ক্রোয়েশীয় RAG-এর জন্য ৩০ কোটি প্যারামিটারের LLM শূন্য থেকে বানালাম — CPU-তে চলে
আগের GPT-2-এর পর, এবার একটি RTX 4090 ব্যবহার করে শূন্য থেকে ক্রোয়েশীয় ভাষার LLM বানিয়ে দেখলাম। লক্ষ্য RAG। দেওয়া লেখার মধ্যে থেকে উত্তর খুঁজে বের করবে এবং প্রমাণ হিসেবে একটি বাক্য উদ্ধৃত করে উত্তর দেবে—এমন একটি মডেল। আর প্রোডাকশনে এটি CPU-তেই চলবে ধরে নেওয়া হয়েছে।
আগে উপসংহারটা বলি।
- শূন্য থেকে সম্পূর্ণ করতে GPU-তে প্রায় ৬৮ ঘণ্টা লেগেছে (পরীক্ষা-নিরীক্ষাসহ)। এর মধ্যে প্রি-ট্রেনিংয়ে ৫১ ঘণ্টা
- ৩২ কোটি প্যারামিটার। অনুচ্ছেদভিত্তিক প্রশ্নে ৭১%, ৩,০০০-টোকেনের দীর্ঘ লেখায় ৪৪% সঠিক
- শুধু CPU-তেই প্রতি প্রশ্নের উত্তর ৩–১৬ সেকেন্ডে দেয়। অক্ষরগুলো যে গতিতে পরপর দেখা যায়, উৎপাদনের গতিও প্রায় ততটাই
প্রশিক্ষণে লাগা সময়
| ধাপ | সময় | বিবরণ |
|---|---|---|
| প্রশিক্ষণ ডেটা তৈরি | প্রায় ৪.৫ ঘণ্টা | EuroLLM-9B (vLLM) দিয়ে Wikipedia QA-এর ৪.৫ লাখ উদাহরণ এবং ৫ লাখ কথোপকথনের অনুবাদ |
| টোকেনাইজার ও টোকেনাইজেশন | প্রায় ২.৫ ঘণ্টা (CPU) | ক্রোয়েশীয়ের জন্য ৩.২ লাখ শব্দভান্ডার নিজে তৈরি |
| প্রি-ট্রেনিং | ৫০ ঘণ্টা ৪৬ মিনিট | ৭০০ কোটি টোকেন। শেষ ১০%-এ কনটেক্সট ৪,০৯৬-এ বাড়ানো |
| SFT | প্রায় ৩৫ মিনিট | উদ্ধৃতিসহ উত্তর দেওয়া এবং উত্তর না থাকলে প্রত্যাখ্যান করা শেখানো |
| রিইনফোর্সমেন্ট লার্নিং (GRPO) | প্রায় ১১ ঘণ্টা | ৪০০ স্টেপ + সমন্বয়ের পর ৩০০ স্টেপ |
নিজস্ব টোকেনাইজারটি GPT-2-এর টোকেনাইজারের প্রায় অর্ধেক টোকেন দিয়ে ক্রোয়েশীয় ভাষা প্রকাশ করতে পারে। অর্থাৎ ৪,০৯৬ টোকেনে প্রায় ১.৭ লাখ অক্ষর পড়া যায়।
তৈরি হওয়া মডেল
| বিষয় | বিবরণ |
|---|---|
| প্যারামিটার | ৩২ কোটি (২৪ স্তর, ১০২৪ মাত্রা) |
| স্থাপত্য | Llama / Qwen3 ধরনের (GQA, SwiGLU, RoPE, RMSNorm + QK-Norm) |
| কনটেক্সট দৈর্ঘ্য | ৪,০৯৬ টোকেন |
| আউটপুট ফরম্যাট | উত্তর + Izvor: „কনটেক্সট থেকে হুবহু নেওয়া ১টি বাক্য“। উত্তর না থাকলে “U tekstu nema odgovora na ovo pitanje.(লেখাটিতে এই প্রশ্নের উত্তর নেই)” |
| চালানো | CPU-কেন্দ্রিক (fp32-এ প্রায় ১.৩GB) |
এ ছাড়া, তৈরি করা উদ্ধৃতিটি সত্যিই কনটেক্সটে আছে কি না প্রোগ্রাম দিয়ে যাচাই করা হয়; না থাকলে সেটি “কোনো উত্তর নেই” দিয়ে বদলে দেওয়ার একটি বাইরের ব্যবস্থা যোগ করা হয়েছে। মডেলকে পুরোপুরি বিশ্বাস না করে, প্রমাণ যাচাই করা যায় এমন ব্যবস্থা করাটাই মূল বিষয়।
বানাতে গিয়ে যে সমস্যাগুলো বোঝা গেল
১. উত্তর না থাকলেও, প্রতিবার বানিয়ে বলে। শুরুতে শুধু সাধারণ প্রশ্নোত্তর শেখানো হয়েছিল। সঠিকতার হার বাড়লেও, যে লেখায় উত্তর নেই তা দিলে ১০০% ক্ষেত্রেই বিশ্বাসযোগ্য-দেখানো উত্তর বানিয়ে দিত। RAG-এ এটাই সবচেয়ে ঝামেলার। তাই উদ্ধৃতি এবং “প্রত্যাখ্যান” শেখানোর পর বানানো উত্তর কয়েক শতাংশে নেমে আসে।
২. অতিরিক্ত প্রত্যাখ্যান। রিইনফোর্সমেন্ট লার্নিংয়ের স্কোরিংয়ে “ভুল হলে −০.৫, প্রত্যাখ্যান করলে ০” দেওয়ায়, কঠিন দীর্ঘ লেখার ক্ষেত্রে প্রত্যাখ্যান করে এড়িয়ে যাওয়াই লাভজনক—এটি শিখে ফেলে, এবং ৭০% ক্ষেত্রেই প্রত্যাখ্যান করতে শুরু করে। স্কোরিং নিয়মের ফাঁকটি একেবারে ঠিকঠাক ধরেছে। প্রত্যাখ্যানের স্কোর −০.৩ করতেই আবার উল্টো দিকে চলে যায়: প্রায় কখনোই প্রত্যাখ্যান করে না, আর বানানো উত্তর ৪০%-এ পৌঁছে যায়। দোলনার মতো এদিক-ওদিক হয়েছে।
৩. উদ্ধৃতি নকল করতে ভুল। দীর্ঘ লেখায় উত্তর ঠিক হলেও উদ্ধৃতির শব্দের ক্রম বদলে দেয়, বা নিবন্ধের প্রথম বাক্য উদ্ধৃত করে। দীর্ঘ কনটেক্সটে উদ্ধৃতিসহ পুরোপুরি সঠিক ছিল প্রায় অর্ধেক ক্ষেত্রে।
৪. যাচাই এড়িয়ে যাওয়া ভুল। কনটেক্সটে মেশানো অন্য নিবন্ধের “〇〇-তে জন্মগ্রহণ করেছিলেন” বাক্যটি হুবহু উদ্ধৃত করে, অন্য ব্যক্তির জন্মস্থানকে উত্তর হিসেবে বলেছে। উদ্ধৃতিটি আসল হওয়ায় যাচাই সেটি আটকাতে পারেনি।
৫. মূল্যায়ন ডেটার ফাঁক। “উত্তরবিহীন কনটেক্সট”-এ উত্তরটির কিছু অংশ রয়ে গিয়েছিল—এমন উদাহরণও ছিল, যেখানে মডেল ঠিক হওয়া সত্ত্বেও তাকে “মনগড়া” হিসেবে চিহ্নিত করা হয়েছিল।
চূড়ান্ত কর্মক্ষমতা
প্রতিটি মূল্যায়নে ৩০০টি প্রশ্ন। সমন্বয় করা রিইনফোর্সমেন্ট লার্নিংয়ের ১০০তম স্টেপের মডেল ব্যবহার করা হয়েছে (প্রত্যাখ্যান ও উত্তর দেওয়ার ভারসাম্য এতে সবচেয়ে ভালো ছিল)।
| কনটেক্সট | সঠিক | ভুল | প্রত্যাখ্যান |
|---|---|---|---|
| অনুচ্ছেদ (প্রায় ১০০–৪০০ টোকেন) | ৭১.৩% | ১৬.৭% | ১২.০% |
| দীর্ঘ কনটেক্সট (১,৫০০–৩,৫০০ টোকেন) | ৪৪.০% | ২০.৩% | ৩৫.৭% |
| উত্তরবিহীন কনটেক্সট | সঠিকভাবে প্রত্যাখ্যান | মনগড়া উত্তর |
|---|---|---|
| অনুচ্ছেদ | ৯৭.৭% | ২.৩% |
| দীর্ঘ কনটেক্সট | ৯২.৩% | ৭.৭% |
যাচাই পেরোনোর পর “উত্তর দেওয়া ক্ষেত্রগুলোর মধ্যে সঠিকের হার” ছিল ৭৩.৮%। ৯০% লক্ষ্যের থেকে এখনও অনেক দূরে।
উল্লেখ্য, একটি প্রশ্ন ৮ বার সমাধান করিয়ে অন্তত একবার সঠিক হলেই OK ধরলে, অনুচ্ছেদে ৯১% এবং দীর্ঘ লেখায় ৭৪% পর্যন্ত সমাধান করতে পেরেছিল (শেষ চেকপয়েন্টে মাপা)। রিইনফোর্সমেন্ট লার্নিংয়ের আগে ও পরে এই সংখ্যাটি প্রায় অপরিবর্তিত ছিল; বদলেছে “প্রতিবার সমাধান করতে পারে কি না”। সংখ্যায় পরিষ্কার দেখা গেছে, রিইনফোর্সমেন্ট লার্নিং নতুন সক্ষমতা যোগ করার চেয়ে মাঝে মাঝে সমাধান করতে পারা সমস্যাকে প্রতিবার সমাধানযোগ্য করে তোলার বিষয়।
CPU-তে চালিয়ে দেখা
পরীক্ষার জন্য একটি Web UI বানিয়ে শুধু CPU (i7-13700K)-তে চালানো হয়েছে। অক্ষর যে গতিতে দেখা যায়, সেটিই উৎপাদনের গতি।
অনুচ্ছেদ (২৬৩ টোকেন): প্রথম অক্ষর আসতে ০.৩ সেকেন্ড, প্রায় ১১ টোকেন/সেকেন্ড, মোট ৭ সেকেন্ড
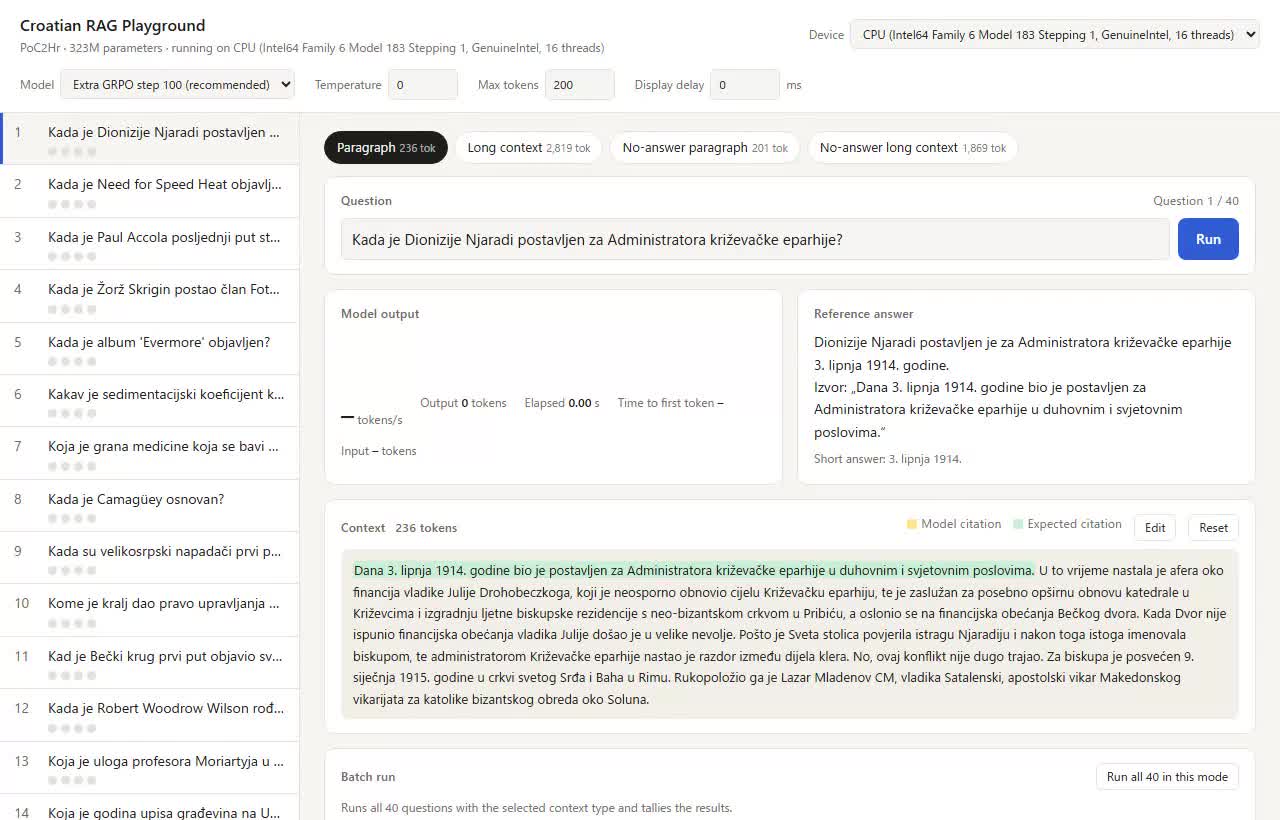
দীর্ঘ কনটেক্সট (৩,২১৫ টোকেন): লেখা পড়তে প্রায় ৫ সেকেন্ড, প্রায় ৫ টোকেন/সেকেন্ড, মোট ১৯ সেকেন্ড। হলুদ অংশটি উদ্ধৃত বাক্য; ৩,০০০ টোকেনের মধ্য থেকে সঠিক একটি বাক্য ঠিকই খুঁজে পেয়েছে
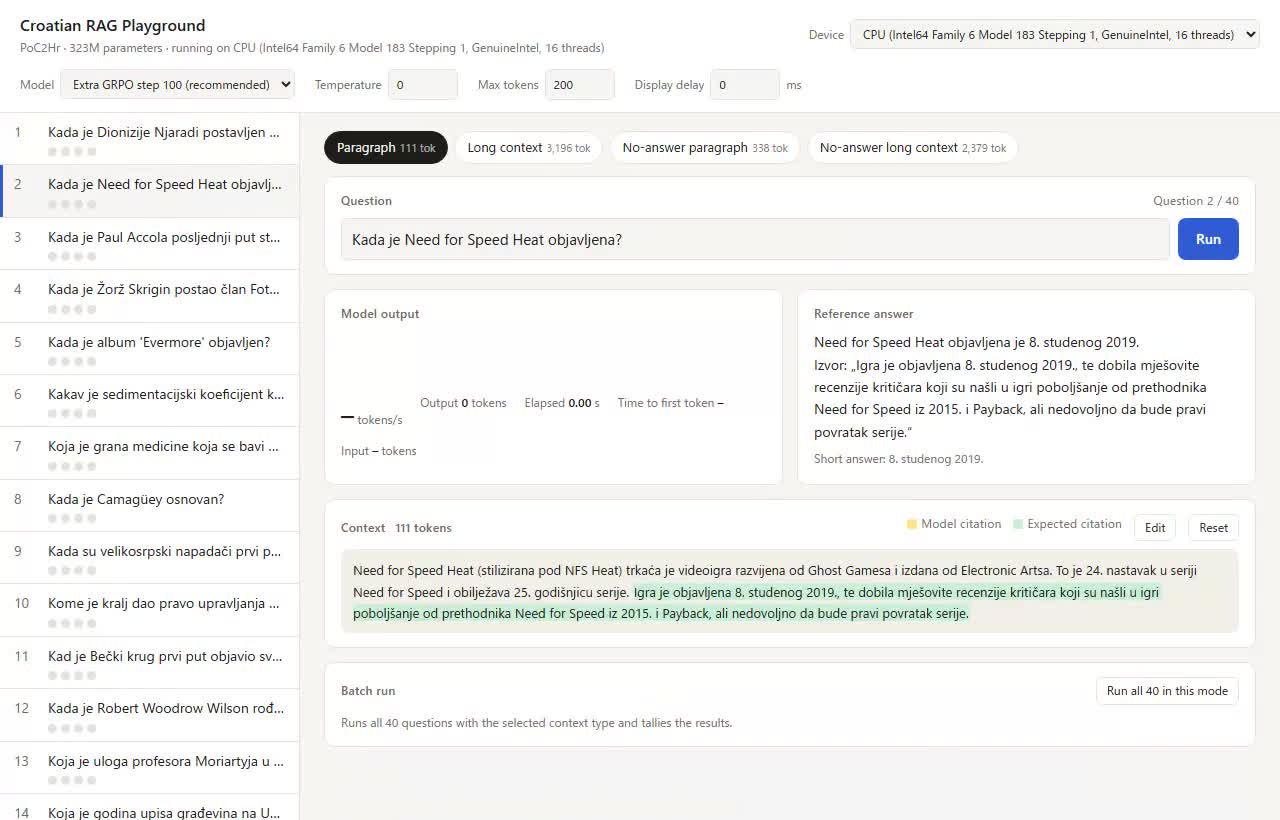
ভিডিওটি রেকর্ড করার সময় নেওয়া হওয়ায় একটু ধীর। রেকর্ডিং ছাড়া ২০টি করে প্রশ্ন মাপলে, অনুচ্ছেদে ১৫ টোকেন/সেকেন্ড ও প্রতি প্রশ্নে ৩.৪ সেকেন্ড, দীর্ঘ কনটেক্সটে ৭ টোকেন/সেকেন্ড ও প্রতি প্রশ্নে ১৬ সেকেন্ড লেগেছে। উত্তরগুলো প্রায় ৫০ টোকেনের এবং ছোট, তাই CPU-তেও ব্যবহারিক গতির বলে মনে হয়।
বিশ্লেষণ
- ছোট মডেলকে “যা জানে না, তা জানে না” বলতে শেখানোই সবচেয়ে গুরুত্বপূর্ণ। RAG-এ সঠিকতার হার বাড়ানোর চেয়ে মনগড়া উত্তর কমানো বেশি কার্যকর। উদ্ধৃতি + প্রত্যাখ্যান + বাইরে থেকে যাচাই—এই সমন্বয় বেশ কাজ করেছে
- ৩২ কোটিতে দীর্ঘ লেখা সীমাবদ্ধতা। ৮ বার সমাধান করালেও দীর্ঘ লেখায় মাত্র ৭৪%-এ পৌঁছায়। দীর্ঘ লেখায় ৯০% চাইলে প্রায় ১০০ কোটি প্যারামিটার দরকার হবে
- যাচাইয়ে শুধু “উদ্ধৃতিটি সত্যিই আছে কি না” দেখলে যথেষ্ট নয়। উদ্ধৃতিতে উত্তরের সংখ্যা বা নাম আছে কি না, কর্তা প্রশ্নের ব্যক্তির সঙ্গে একই কি না—এসবও যাচাই করতে হবে
- CPU-তে চলা ৩২ কোটি প্যারামিটারের মডেল ইন্টারনেটে প্রকাশ করা যায় না এমন নথির Q&A-এর জন্য বেশ উপযোগী। GPU ছাড়াই ল্যাপটপ বা সার্ভারে, কেবল হাতের কাছে থাকা নথির ভিত্তিতে উত্তর দেওয়ানো যায়। গতি প্রতি প্রশ্নে কয়েক সেকেন্ড থেকে এক ডজন সেকেন্ডের মতো; কোয়ান্টাইজ করলে আরও দ্রুত হওয়ার কথা (অপরীক্ষিত)
পরের বার ১০০ কোটি প্যারামিটারের সংস্করণে, দীর্ঘ কনটেক্সটে ৯০% লক্ষ্য করতে চাই।