SLM-এর RAG কর্মক্ষমতা যাচাই: ক্রোয়েশীয় ও ইংরেজিতে ১B–৯B-এর ২৫টি মডেলের তুলনা
নিজের তৈরি ক্রোয়েশীয় RAG মডেল বানিয়ে কোয়ান্টাইজেশন পর্যন্ত করার পর, এবার ভাবলাম বিশ্বের ছোট মডেলগুলো (SLM) RAG-এ আসলে কতটা ব্যবহারযোগ্য, সেটা দেখি। 1B-শ্রেণির 10টি, 3B-শ্রেণির 8টি, 7B-শ্রেণির 7টি—মোট 25টি মডেলের সঙ্গে নিজের তৈরি 320M মডেলটিও যোগ করে, ক্রোয়েশীয় ও ইংরেজি—দুই ভাষায় একই সমস্যা সমাধান করিয়েছি।
সংযোজন (একই দিন): RAG-এর জন্য বিশেষভাবে বানানো 3টি ছোট মডেলও (LFM2-1.2B-RAG, Pleias-RAG-1B / 350M) পরীক্ষা করেছি। ফলাফল নিবন্ধের পরের অংশের 「সংযোজন: RAG-নির্দিষ্ট মডেলও পরীক্ষা করে দেখলাম」-এ আছে।
আগে উপসংহার বলি।
- 3–4B শ্রেণিই এখন প্রায় 8–9B শ্রেণির সমকক্ষ। ক্রোয়েশীয় ভাষায় সামগ্রিক সঠিকতার হার Qwen3.5 4B ও Gemma 4 E4B-এর 90%, আর সবার ওপরে থাকা Qwen3.5 9B-এর 91%
- ফারাক গড়ে দেয়, উত্তর না থাকলে মডেলটি উত্তর দিতে অস্বীকার করতে পারে কি না। সঠিকতার শীর্ষস্থানীয় Phi-4-mini, উত্তরহীন দীর্ঘ লেখার 64%-এ উত্তর বানিয়ে বলেছে
- ইংরেজিতে এমন মডেল বেশি, যারা উত্তর থাকা সত্ত্বেও অস্বীকার করে। OLMo 3 7B ইংরেজি অনুচ্ছেদের 47%, আর MiniCPM5 2B 70% অস্বীকার করেছে
- CPU-তে 7B শ্রেণির মডেলের একটি দীর্ঘ প্রশ্নে 30 সেকেন্ডেরও বেশি লাগে। 1B শ্রেণিতে লাগে 4–13 সেকেন্ড। নিজের তৈরি 320M মডেলটিতে লাগে 2.1 সেকেন্ড, আর নির্ভুলতা Qwen3.5 0.8B-এর কাছাকাছি
যা করেছি
সমস্যা: আগের নিবন্ধের মতোই, ক্রোয়েশীয় সংস্করণের Wikipedia থেকে তৈরি প্রশ্ন। প্রতি প্রশ্নে 4 ধরনের লেখা দেওয়া হয়।
- অনুচ্ছেদ: উত্তর থাকা প্রায় 100 টোকেনের একটি অনুচ্ছেদ
- দীর্ঘ লেখা: উত্তর থাকা প্রায় 3,000 টোকেনের লেখা (এতে সম্পর্কহীন নিবন্ধও মেশানো থাকে)
- উত্তর নেই (অনুচ্ছেদ・দীর্ঘ লেখা): যে লেখায় উত্তর নেই। “মূল লেখায় উত্তর নেই” বলে অস্বীকার করতে পারলে সেটি সঠিক ধরা হয়েছে
ইংরেজি সংস্করণ: একই সমস্যাগুলোকে EuroLLM-9B দিয়ে ইংরেজিতে অনুবাদ করেছি। অনুবাদে যেখানে উত্তর হারিয়ে গেছে বা অনুবাদ না হয়ে ক্রোয়েশীয়ই থেকে গেছে, সেই প্রশ্নগুলো দুই ভাষা থেকেই বাদ দিয়ে একই 260টি প্রশ্নে তুলনা করেছি।
নির্দেশনা: প্রতিটি ভাষায় বলা হয়েছে, “নিচের লেখাটিই কেবল ব্যবহার করে এক বাক্যে সংক্ষেপে উত্তর দাও। উত্তর না থাকলে শুধু ‘মূল লেখায় উত্তর নেই’ বলো।”
মূল্যায়ন: Qwen3.5 9B-কে আদর্শ উত্তরের সঙ্গে মিলিয়ে “সঠিক・ভুল・অস্বীকার করেছে” নির্ধারণ করতে দিয়েছি। নিজে 65টি উদাহরণ দেখে যাচাই করে দেখেছি, শুধু বছর বলার মতো আংশিক উত্তরকেও সঠিক ধরায় মূল্যায়নটি কিছুটা উদার ছিল; তবে অস্বীকার করেছে কি না, সেই রায় সবক্ষেত্রে মিলেছে।
সামগ্রিক সঠিকতার হার: অনুচ্ছেদ ও দীর্ঘ লেখায় সঠিক উত্তর দিতে পারা সংখ্যা এবং উত্তর না থাকলে অস্বীকার করতে পারা সংখ্যা যোগ করে, মোট প্রশ্নসংখ্যা দিয়ে ভাগ করা হয়েছে। সঠিক উত্তর দেওয়া এবং না জানলে চুপ থাকা—দুটিই বিবেচনায় আনে এই সংখ্যা।
চালানোর পদ্ধতি: নির্ভুলতা মাপা হয়েছে RTX 4090-এ vLLM দিয়ে, প্রতিবার সবচেয়ে বেশি সম্ভাবনাযুক্ত শব্দ বেছে নিয়ে তৈরি করার পদ্ধতিতে। চিন্তা করে উত্তর দেওয়ার “থিংকিং মোড” থাকা মডেলগুলোর সেটি বন্ধ রাখা হয়েছে। 7B শ্রেণির মডেলগুলো GPU মেমরিতে ধরানোর জন্য FP8 করা হয়েছে।
ফলাফল: নির্ভুলতা (ক্রোয়েশীয়)
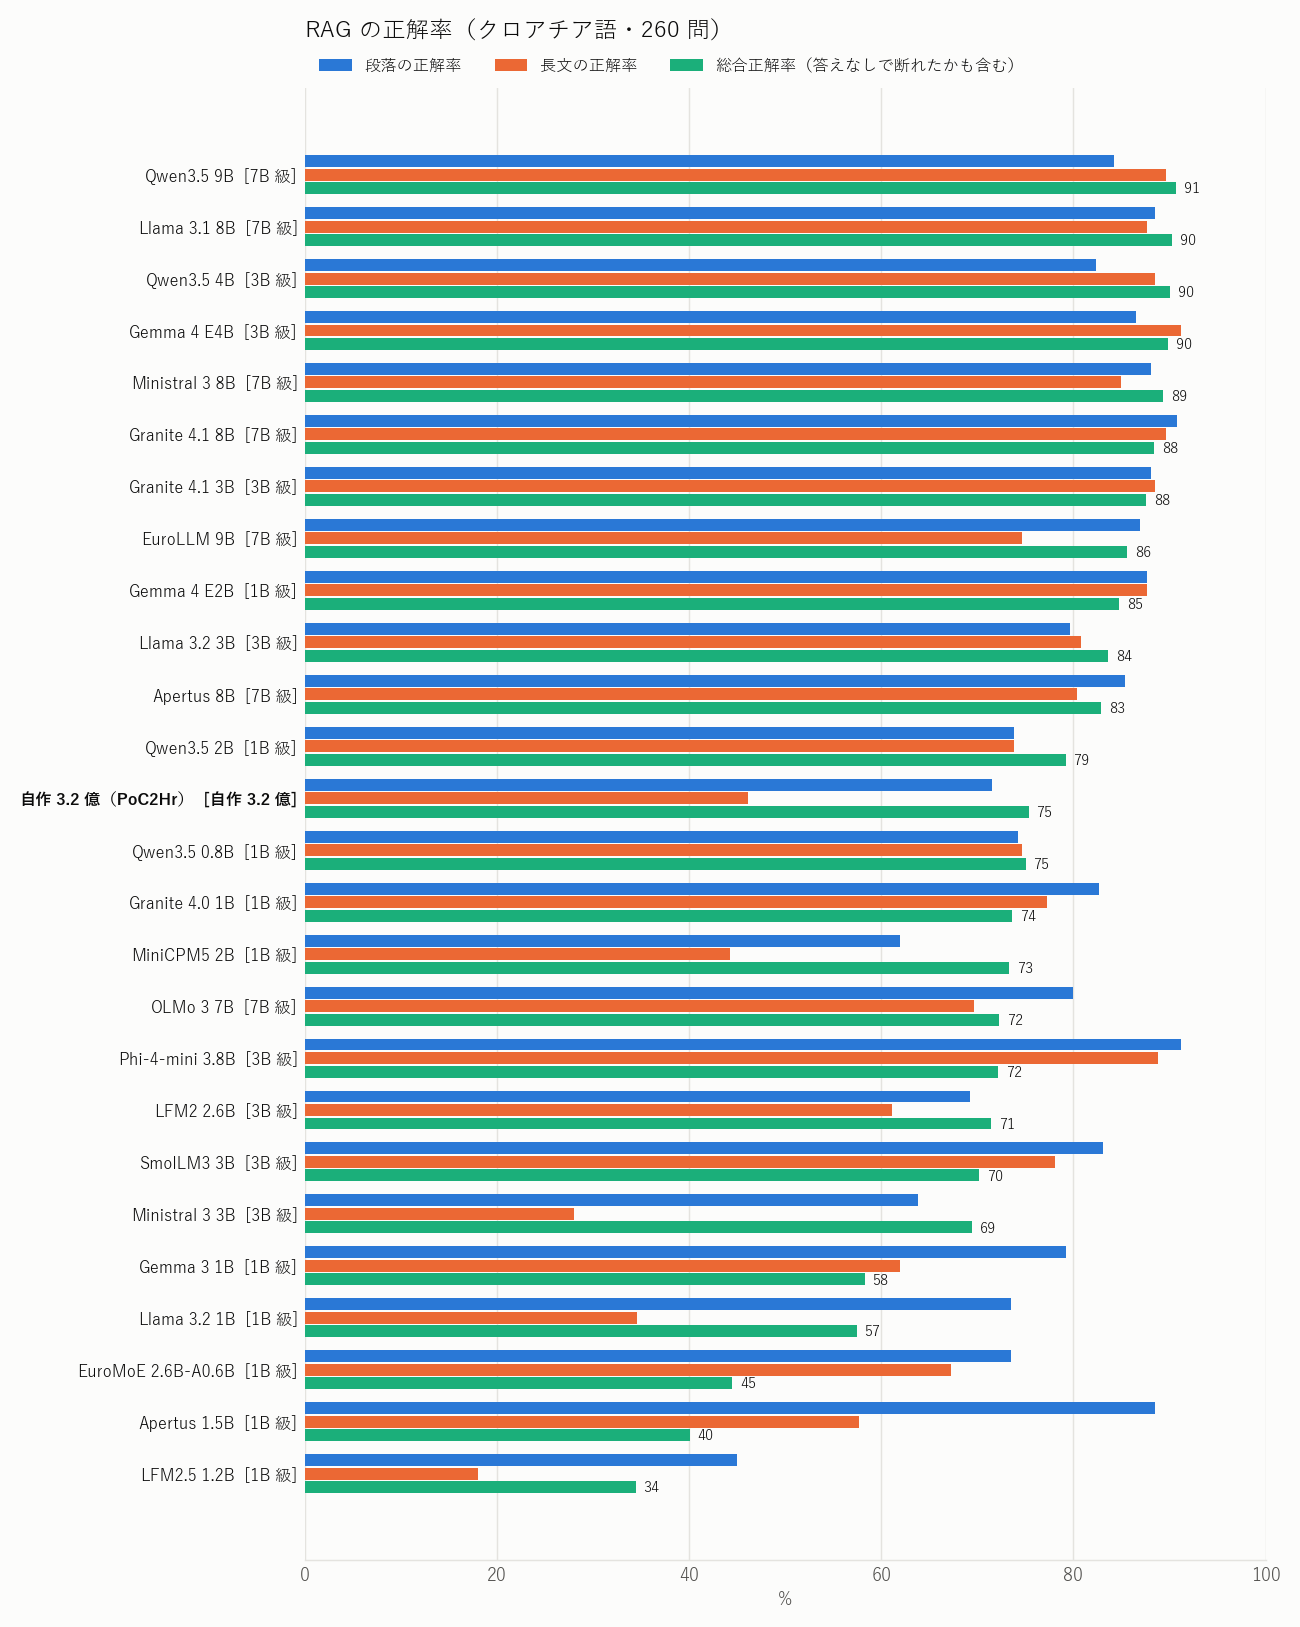
- শীর্ষ মডেলগুলো প্রায় 90%-এ সমান অবস্থানে। Qwen3.5 9B (91%), Llama 3.1 8B, Qwen3.5 4B, Gemma 4 E4B (90%)
- 1B শ্রেণিতে Gemma 4 E2B এগিয়ে (85%)। তবে নাম 2B হলেও, ফাইলটি তুলনামূলক বড়—3.2GB
- অনুচ্ছেদ ও দীর্ঘ লেখার সঠিকতার হার বেশি হলেও, কিছু মডেলের সামগ্রিক স্কোর নেমে যায়। Phi-4-mini অনুচ্ছেদে 91% ও দীর্ঘ লেখায় 89% নিয়ে শীর্ষ গোষ্ঠীতে থাকলেও, সামগ্রিক স্কোর 72%। কারণ হলো পরের “মনগড়া উত্তর” সমস্যা
- সবচেয়ে খারাপ ছিল LFM2.5 1.2B (34%)। উত্তর থাকা প্রশ্নে এটি সঠিক উত্তর দিতে পারেনি, আর উত্তর না থাকা প্রশ্নে বানিয়ে বলেছে
ফলাফল: নির্ভুলতা (ইংরেজি)
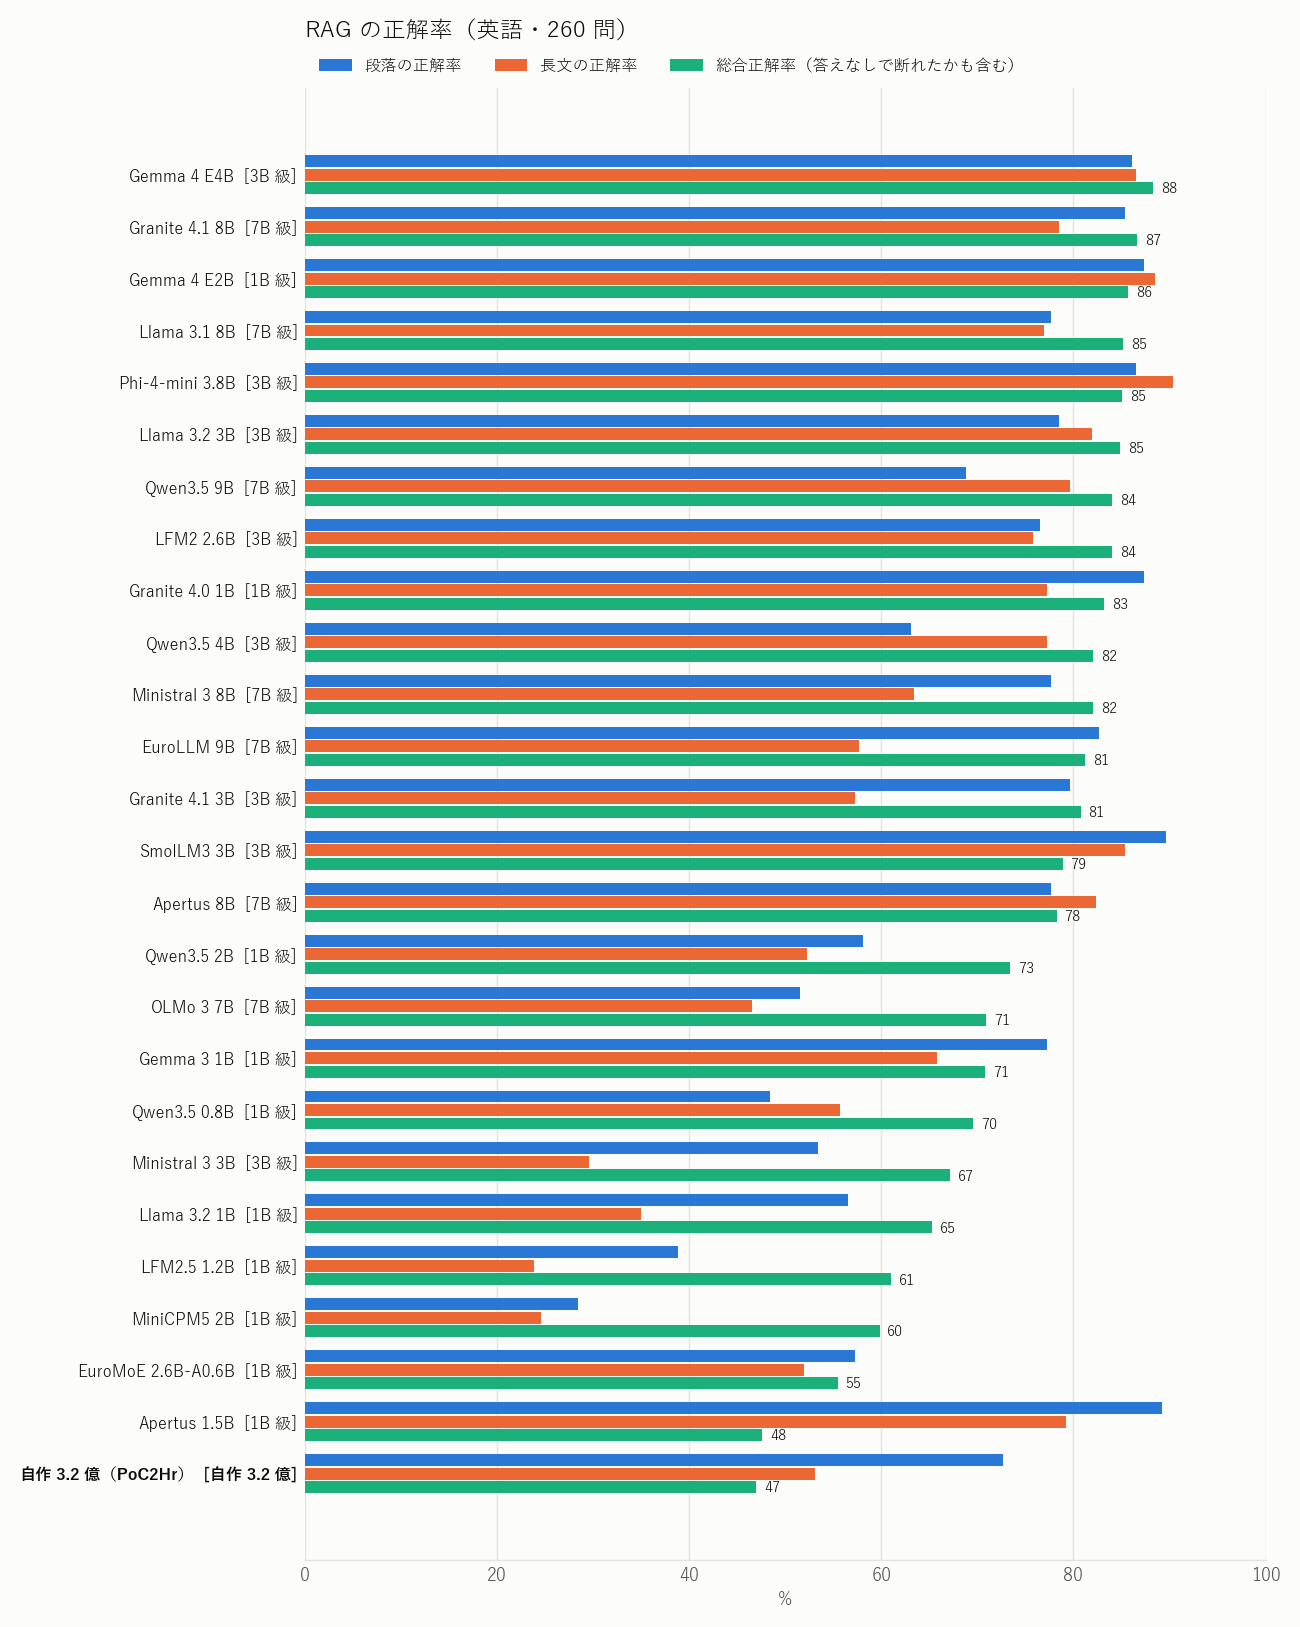
- সবার ওপরে Gemma 4 E4B (88%)। Gemma 4 E2B-ও 86%, তাই Gemma 4 দুই ভাষাতেই স্থিতিশীল
- ইংরেজিতে কিছু মডেলের র্যাঙ্ক নেমে যায়। Qwen3.5 4B ক্রোয়েশীয়ে 90% → ইংরেজিতে 82%। কারণ উত্তর থাকা সত্ত্বেও অস্বীকার করা (অনুচ্ছেদের 35%)
যা জানা গেল 1: ফারাক গড়ে দেয় “অস্বীকার করতে পারা”
উত্তরহীন দীর্ঘ লেখা দিলে, মনগড়া উত্তর বলার হার (ক্রোয়েশীয়)।
| মডেল | উত্তরহীন দীর্ঘ লেখায় মনগড়া উত্তর |
|---|---|
| Qwen3.5 4B | 9% |
| নিজের তৈরি 320M | 9% |
| Qwen3.5 9B | 10% |
| Gemma 4 E4B | 19% |
| Granite 4.1 8B | 30% |
| Phi-4-mini 3.8B | 64% |
| SmolLM3 3B | 73% |
| EuroMoE 2.6B-A0.6B | 94% |
উদাহরণ হিসেবে, “Need for Speed Heat কবে প্রকাশিত হয়েছিল?” জিজ্ঞেস করে এমন দীর্ঘ লেখা দেওয়া হলো যাতে উত্তর নেই। Qwen3.5 9B বলেছে “মূল লেখায় উত্তর নেই”, কিন্তু Phi-4-mini বলেছে “1969 সালের আগস্টে”। সম্ভবত লেখার কোথাও থাকা একটি তারিখ কুড়িয়ে এনেছে।
RAG-এ এটাই সবচেয়ে বড় সমস্যা। শুধু সঠিকতার হার দেখে মডেল বেছে নেওয়া বিপজ্জনক। যে উত্তরগুলো দিয়েছে, তার মধ্যে সঠিক উত্তরের হার Qwen3.5-এর 4B ও 9B-এ সর্বোচ্চ—91–92%; Phi-4-mini-তে ছিল মাত্র 64%।
যা জানা গেল 2: ইংরেজিতে অতিরিক্ত অস্বীকার করে
উল্টো দিকে, ইংরেজিতে উত্তর স্পষ্টভাবে লেখা থাকা সত্ত্বেও অস্বীকার করা মডেল অনেক ছিল। উত্তর থাকা অনুচ্ছেদ দেওয়ার পর অস্বীকার করার হার নিচে দেওয়া হলো।
| মডেল | ক্রোয়েশীয় | ইংরেজি |
|---|---|---|
| Qwen3.5 4B | 15% | 35% |
| Qwen3.5 0.8B | 17% | 47% |
| OLMo 3 7B | 8% | 47% |
| MiniCPM5 2B | 34% | 70% |
| Gemma 4 E4B | 9% | 8% |
উদাহরণ হিসেবে, “Paul Accola শেষবার কবে পডিয়ামে উঠেছিলেন?” ইংরেজি অনুচ্ছেদে “the last time in 2000” স্পষ্ট করে লেখা থাকলেও Qwen3.5 4B বলেছে “মূল লেখায় উত্তর নেই”। একই প্রশ্ন ক্রোয়েশীয় ভাষায় করলে এটি সঠিকভাবে “2000 সাল” উত্তর দেয়।
কারণ এখনও জানা যায়নি। ইংরেজি সংস্করণটি যন্ত্রঅনুবাদ, তাই বাক্যের অস্বাভাবিকতা প্রভাব ফেলতে পারে; কিংবা ইংরেজিতে “উত্তর না থাকলে এভাবে উত্তর দাও” নির্দেশনার প্রতি এটি বেশি তীব্রভাবে প্রতিক্রিয়া দেখাতে পারে।
ফলাফল: CPU-তে গতি
আমার ব্যবহারের ক্ষেত্রে CPU-তে চালানোই ধরে নেওয়া, তাই সব মডেলকে llama.cpp-এর একই ফরম্যাটে (Q4_K_M) রূপান্তর করে i7-13700K-এ মেপেছি। জেনারেশনে 8টি থ্রেড, লেখা পড়ার জন্য 16টি থ্রেড ব্যবহার করা হয়েছে। শুধু Ministral 3 ঠিকমতো রূপান্তর করা যায়নি, তাই Mistral-এর অফিসিয়াল Q4_K_M ব্যবহার করেছি।
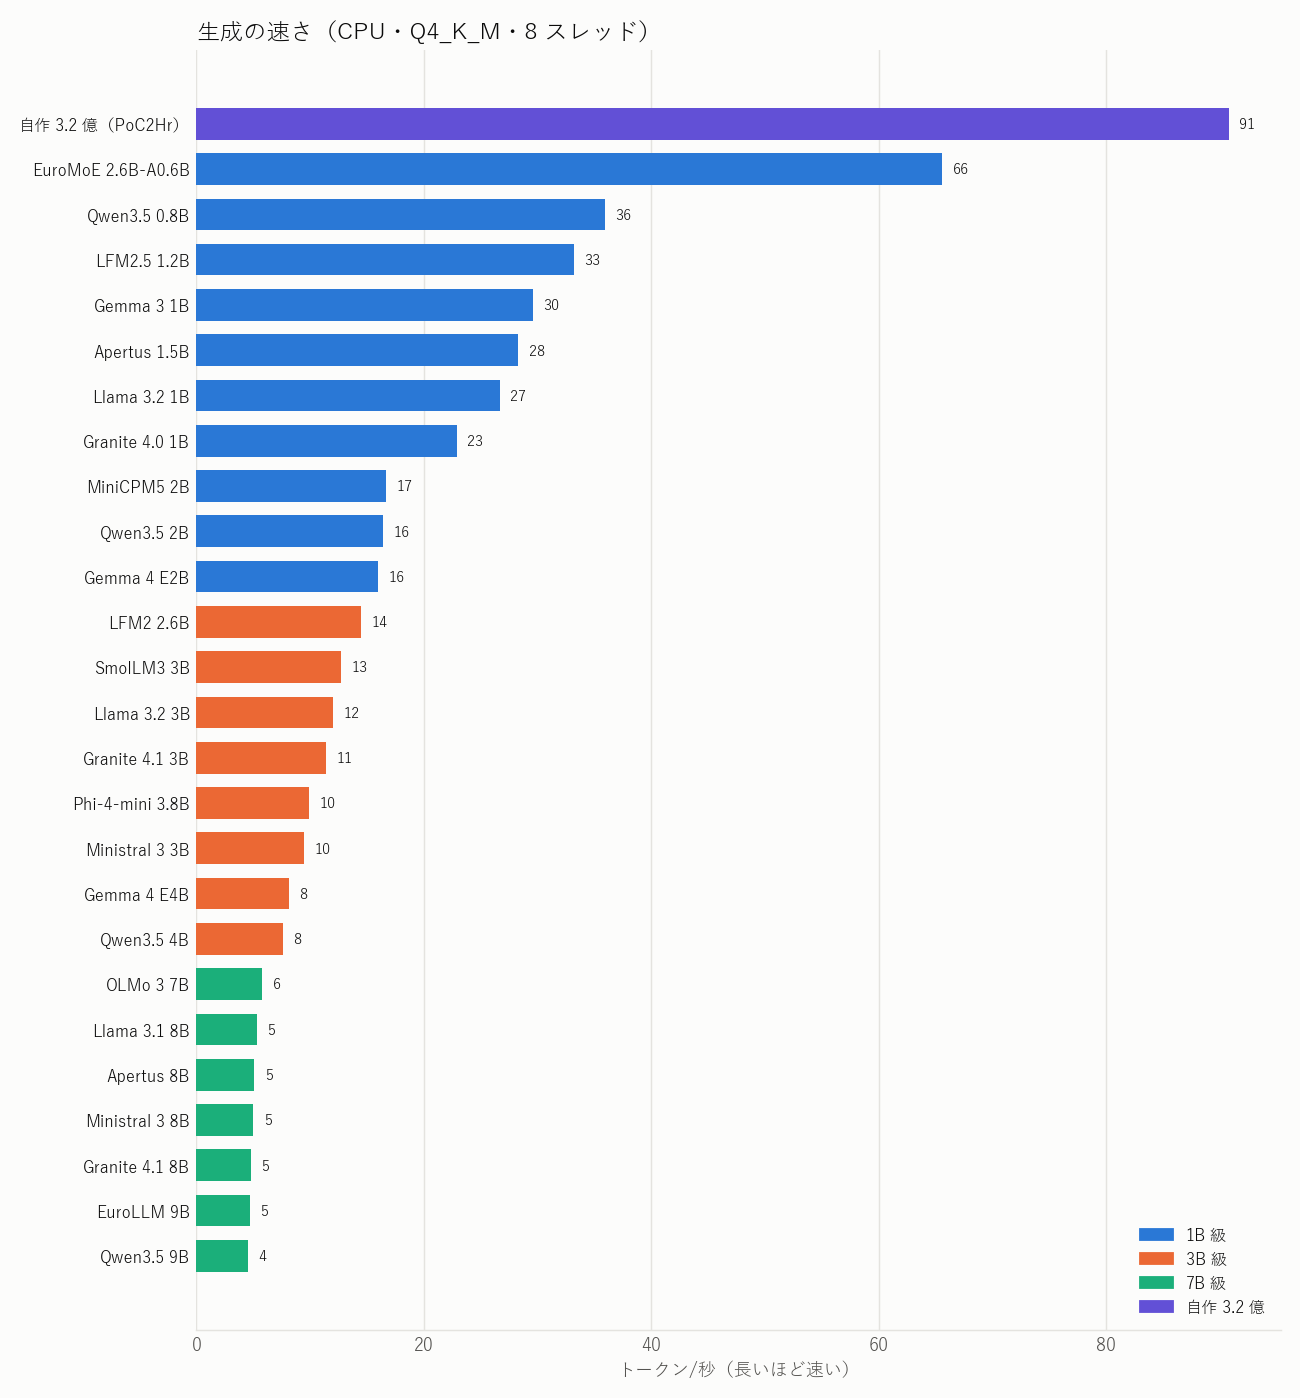
একটি দীর্ঘ প্রশ্নের উত্তর দিতে সময়ও অনুমান করেছি। প্রতিটি মডেলের ক্ষেত্রে দীর্ঘ লেখার ইনপুট টোকেন পড়তে যত সময় লাগে, তার সঙ্গে গড় উত্তরদৈর্ঘ্য তৈরি করতে যত সময় লাগে—দুটির যোগফল।
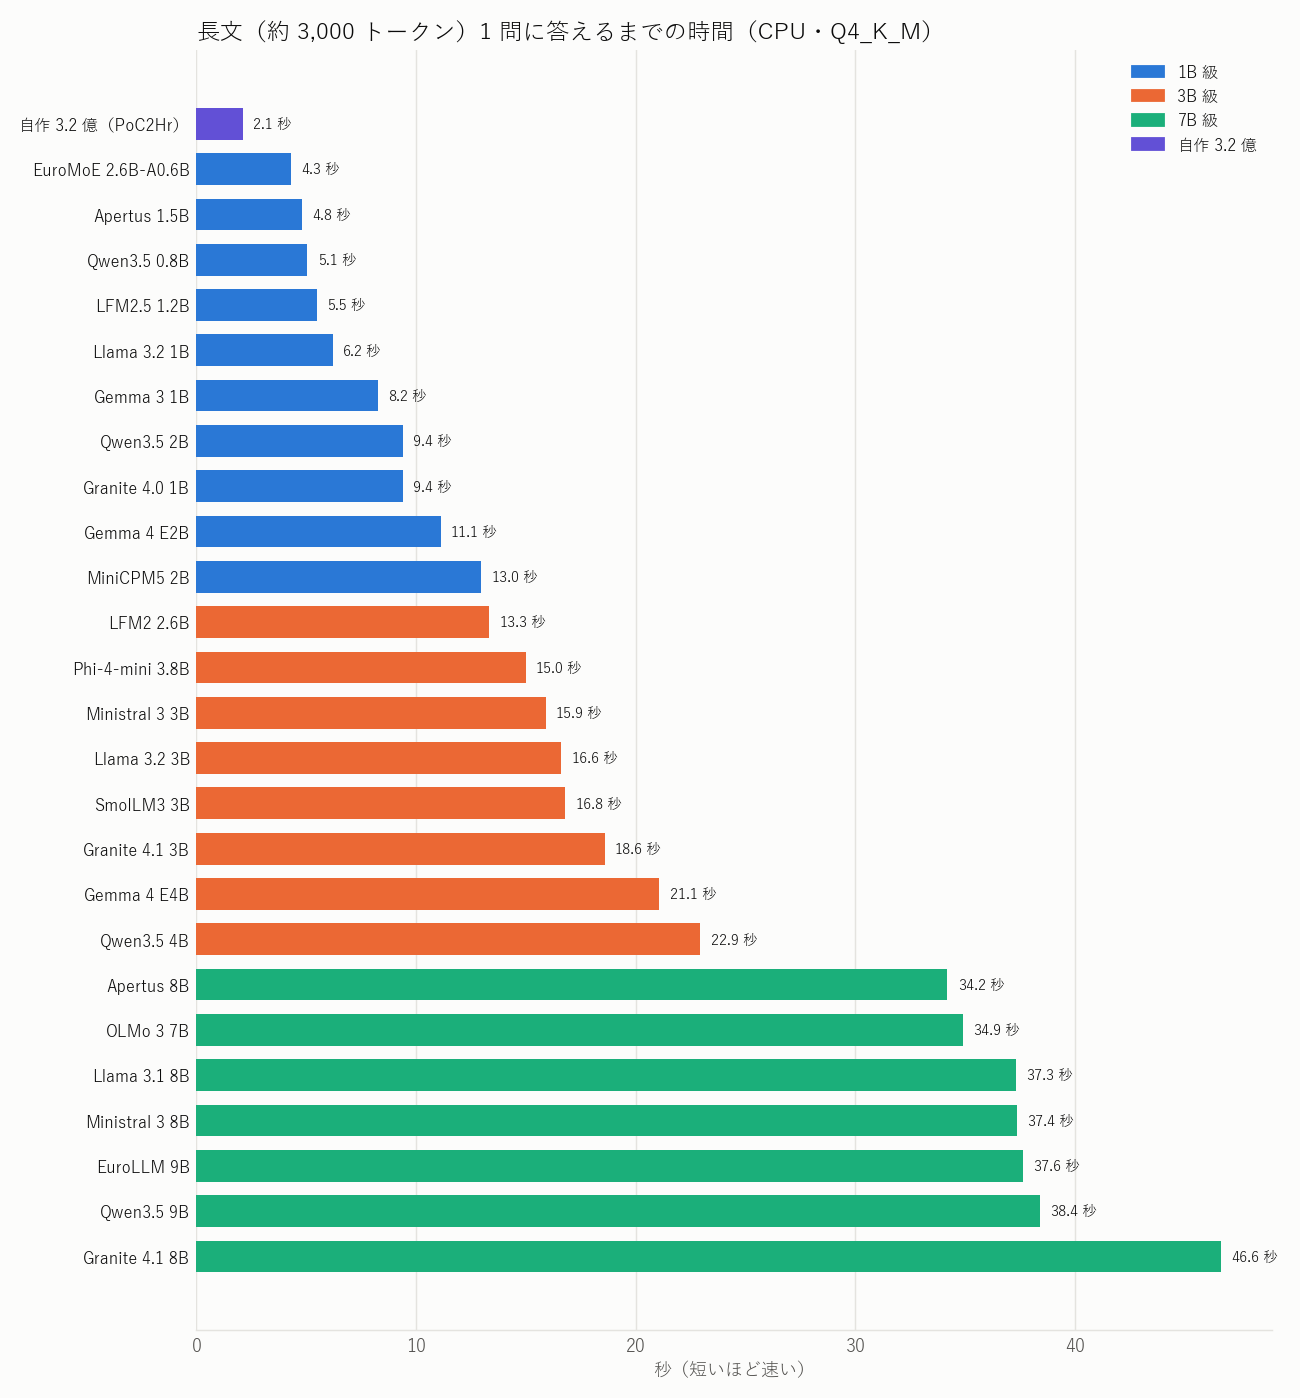
- জেনারেশনের গতি মোটামুটি আকারের ব্যস্তানুপাতিক। 7B শ্রেণিতে প্রতি সেকেন্ডে প্রায় 5 টোকেন, এবং একটি দীর্ঘ প্রশ্নে 34–47 সেকেন্ড
- 3B শ্রেণিতে 13–23 সেকেন্ড, 1B শ্রেণিতে 4–13 সেকেন্ড
- একই দীর্ঘ লেখাতেও মডেলভেদে ইনপুট টোকেনসংখ্যা 2,443–3,796 পর্যন্ত ভিন্ন। ক্রোয়েশীয়কে টোকেনাইজার কতটা সংক্ষিপ্তভাবে প্রকাশ করতে পারে তার পার্থক্য এটি, এবং ক্রোয়েশীয়-নির্দিষ্টভাবে বানানো নিজের টোকেনাইজারটিই সবচেয়ে সংক্ষিপ্ত
গতি ও নির্ভুলতা পাশাপাশি দেখলে
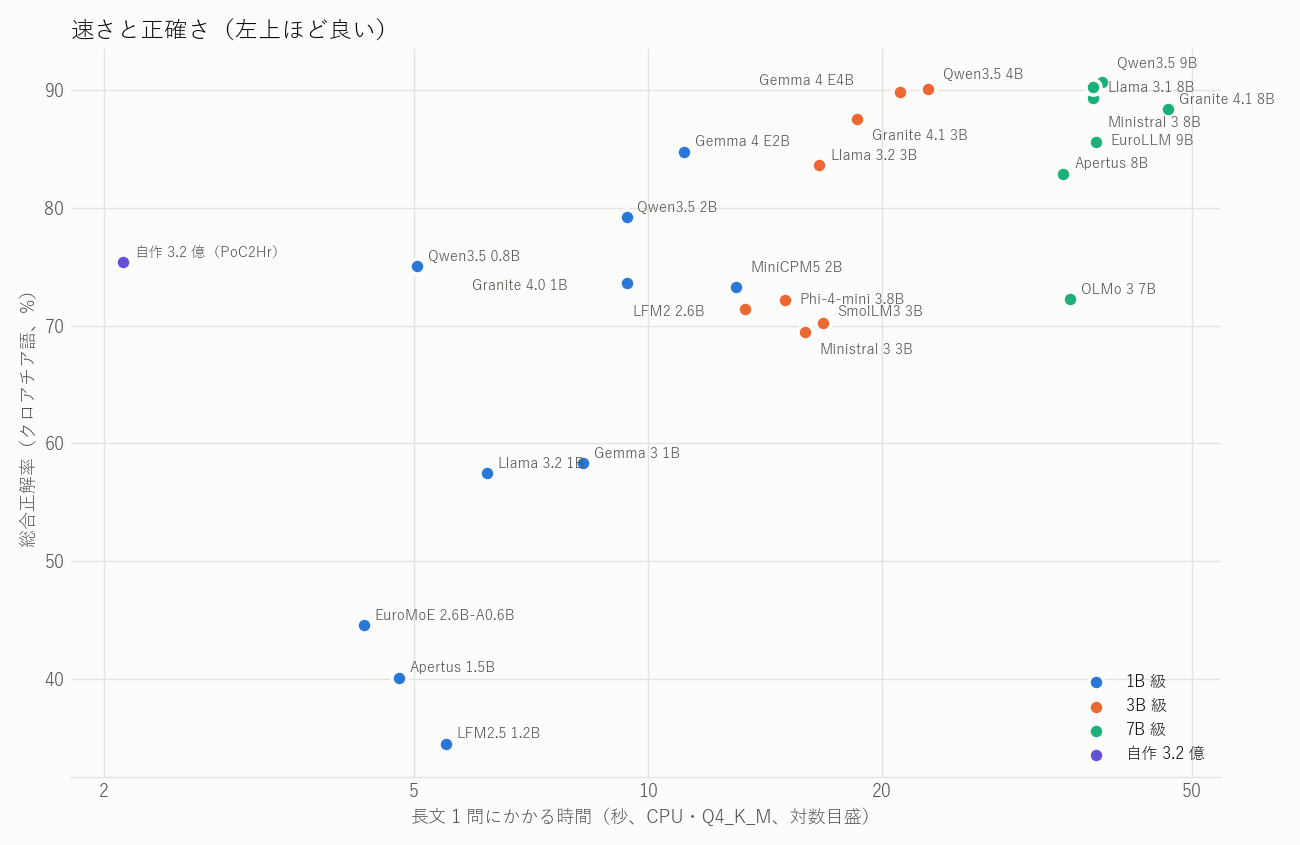
যত বেশি বাম-ওপরে, তত “দ্রুত ও নির্ভুল”।
- সুষম পছন্দ Gemma 4 E2B (11 সেকেন্ড・85%) এবং Qwen3.5 2B (9 সেকেন্ড・79%)
- নির্ভুলতাকে অগ্রাধিকার দিলে Qwen3.5 4B বা Gemma 4 E4B (21–23 সেকেন্ড・90%)। 7B শ্রেণির চেয়ে 1.5 গুণেরও বেশি দ্রুত, আর নির্ভুলতা প্রায় একই
- নিজের তৈরি 320M মডেলের গতি আলাদা স্তরের (2.1 সেকেন্ড)। সামগ্রিক সঠিকতার হার 75%, যা Qwen3.5 0.8B-এর সমান; আর মনগড়া উত্তর কম বলার দিকটি শীর্ষ মডেলগুলোর মতো। তবে দীর্ঘ লেখায় সঠিকতার হার 46%, যা Qwen3.5 0.8B (75%) ও Gemma 4 E2B (88%)-এর চেয়ে স্পষ্টতই দুর্বল
- নিজের তৈরি মডেলটি ইংরেজিতে প্রশিক্ষিত নয়, তাই ইংরেজিতে উত্তরহীন দীর্ঘ লেখার 91%-এ এটি মনগড়া উত্তর বলেছে
সতর্কতা
- মূল্যায়নটি LLM দিয়ে করা, তাই নিখুঁত নয়। এতে কিছুটা উদার মূল্যায়ন হয়েছে
- ইংরেজি সংস্করণটি যন্ত্রঅনুবাদ। প্রশ্ন তৈরি করা ও অনুবাদ—দুটিই EuroLLM-9B দিয়ে করা হয়েছে, তাই EuroLLM সামান্য সুবিধা পেয়ে থাকতে পারে (ফলাফল ছিল মাঝারি, 86%)
- Apertus 1.5B সর্বোচ্চ 4,096 টোকেনের প্রসঙ্গ সামলাতে পারে, ফলে ক্রোয়েশীয় দীর্ঘ লেখার 23% এতে ঢোকেনি। যে অংশ ঢোকেনি, তা ভুল হিসেবে গণনা করা হয়েছে
- নির্ভুলতা মাপা হয়েছে GPU-তে (vLLM, 7B শ্রেণিতে FP8), আর গতি CPU-তে (Q4_K_M)—অর্থাৎ পরীক্ষার পরিবেশ আলাদা। কোয়ান্টাইজেশনে নির্ভুলতা সামান্য বদলাতে পারে
- গতি মাপা হয়েছে এমন একটি PC-তে, যেখানে সাধারণত ব্যবহৃত অ্যাপ্লিকেশনগুলো খোলা ছিল। সব মডেলকে একই শর্তে ধারাবাহিকভাবে মাপা হয়েছে, তাই তুলনার জন্য ব্যবহারযোগ্য বলে মনে করি
আলোচনা
- RAG ব্যবহারের জন্য 4B এখন যথেষ্ট। 3–4B শ্রেণির সেরা মডেলগুলো 7–9B শ্রেণির মতোই নির্ভুল, আর CPU-তে 1.5–2 গুণ দ্রুত
- মডেল বাছাইয়ে “অস্বীকার করতে পারে কি না” অবশ্যই দেখা উচিত। সঠিকতার হার কাছাকাছি হলেও, উত্তরহীন লেখায় মনগড়া উত্তর বলার হার মডেলভেদে 1% থেকে 99% পর্যন্ত বিচিত্র। RAG-এ অনুসন্ধানে সম্পর্কহীন লেখা পাওয়া খুব সাধারণ, তাই এই দিকটিই সবচেয়ে গুরুত্বপূর্ণ
- একই মডেলের আচরণও ভাষাভেদে বদলে যায়। ইংরেজিতে অতিরিক্ত সতর্ক হয়ে উত্তর হাতছাড়া করা মডেল অনেক ছিল। ব্যবহারের ভাষায় বাস্তবে পরীক্ষা না করলে তা জানা যায় না
- নিজের তৈরি মডেলের চ্যালেঞ্জ দীর্ঘ লেখা। অস্বীকার করার ক্ষমতা ও গতি যথেষ্ট; দীর্ঘ লেখায় সঠিকতার হার বাড়াতে পারলে “CPU-তে চলা RAG মডেল” হিসেবে এটি বেশ কার্যকর হওয়ার কথা। পরের লক্ষ্য এটিই উন্নত করা
সংযোজন: RAG-নির্দিষ্ট মডেলও পরীক্ষা করে দেখলাম
“RAG-এর জন্য বিশেষভাবে টিউন করা মডেলগুলো কেমন?” ভাবায়, ছোট 3টি RAG-নির্দিষ্ট মডেল অতিরিক্ত পরীক্ষা করেছি। শর্ত ওপরের মতোই (একই 260টি প্রশ্ন, একই মূল্যায়ন)।
- LFM2-1.2B-RAG (Liquid AI): LFM2-1.2B-কে নথি দিয়ে উত্তর দেওয়ার 10 লক্ষের বেশি উদাহরণে অতিরিক্ত প্রশিক্ষণ দেওয়া হয়েছে। সমর্থিত ভাষা ইংরেজি, জাপানিসহ 9টি; ক্রোয়েশীয় এতে নেই
- Pleias-RAG-1B / Pleias-RAG-350M (PleIAs): RAG-এর প্রায় 31 লক্ষ সিন্থেটিক ডেটায় প্রশিক্ষিত মডেল। উত্তর দেওয়ার আগে “প্রশ্ন বিশ্লেষণ → উপকরণ বিশ্লেষণ → খসড়া” লেখে, এবং উত্তরের সঙ্গে মূল লেখা থেকে উদ্ধৃতি দেয়। সমর্থিত ভাষা ইউরোপের 7টি ভাষা; ক্রোয়েশীয় এতে নেই। সর্বোচ্চ 4,096 টোকেনের প্রসঙ্গ সামলাতে পারে
- তুলনার জন্য LFM2-1.2B-RAG-এর ভিত্তি হওয়া মূল LFM2-1.2B-ও মেপেছি
LFM2-1.2B-RAG-কে অন্য মডেলগুলোর মতোই নির্দেশনা দেওয়া হয়েছে। Pleias কেবল বিশেষ ইনপুট ফরম্যাট গ্রহণ করে (প্রশ্ন ও উপকরণকে বিশেষ চিহ্ন দিয়ে আলাদা করা), তাই অফিসিয়াল লাইব্রেরির মতো একই ফরম্যাটে দিয়ে শুধু শেষ উত্তরের অংশটি মূল্যায়ন করেছি। ফলে Pleias-কে “উত্তর না থাকলে এভাবে উত্তর দাও” নির্দেশনা দেওয়া যায়নি।
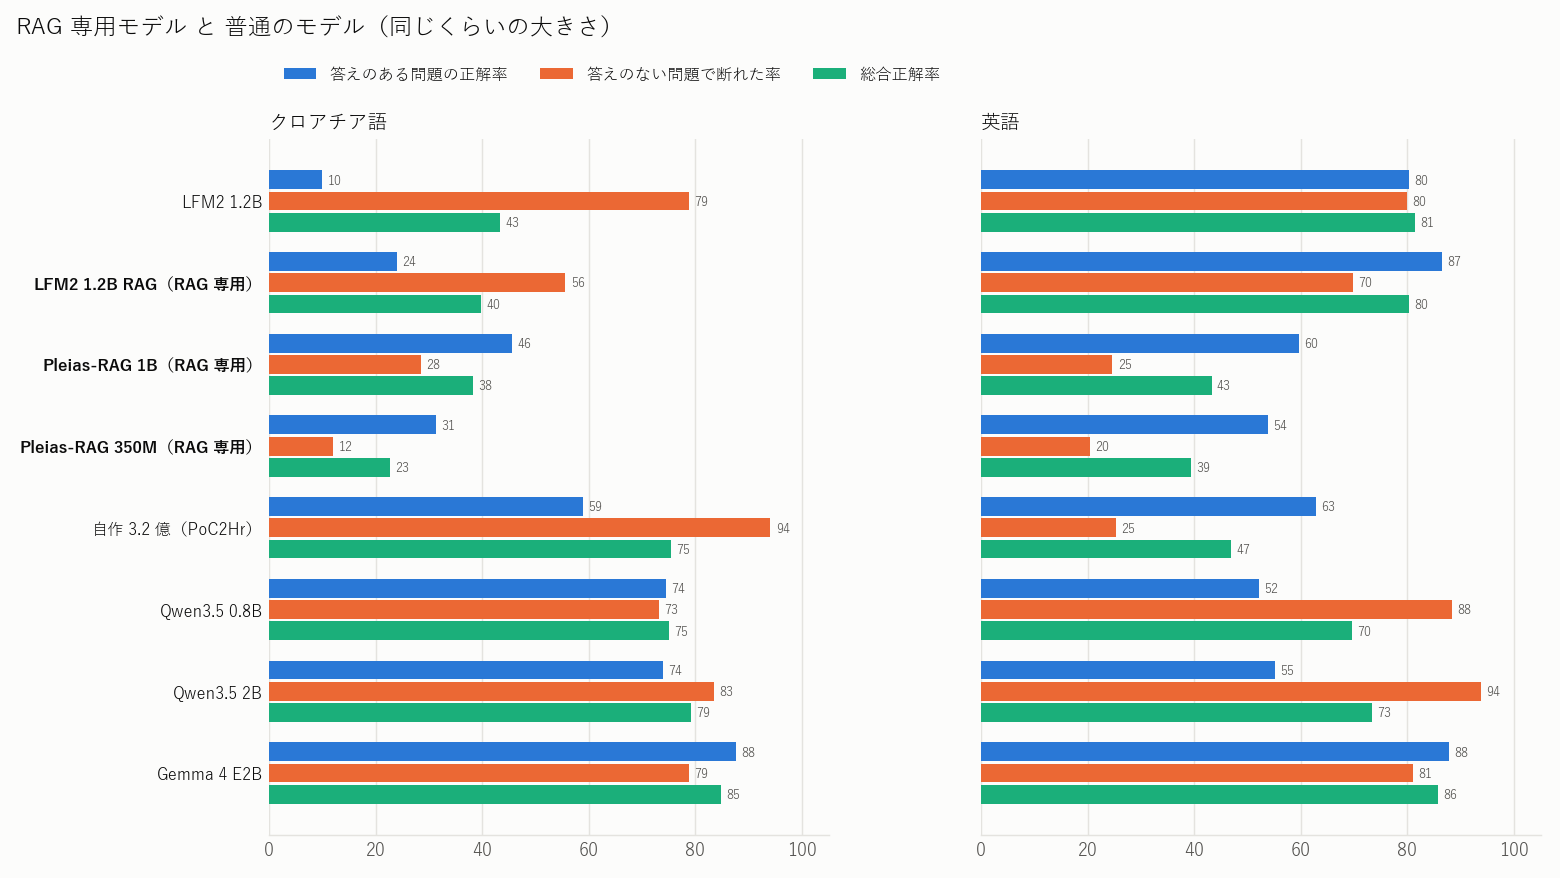
| মডেল | সামগ্রিক (ক্রোয়েশীয়) | সামগ্রিক (ইংরেজি) | উত্তরহীন দীর্ঘ লেখায় মনগড়া উত্তর (ক্রোয়েশীয় / ইংরেজি) | একটি দীর্ঘ প্রশ্নের সময় (CPU) |
|---|---|---|---|---|
| LFM2 1.2B (মূল মডেল) | 43% | 81% | 42% / 36% | 7.8 সেকেন্ড |
| LFM2 1.2B RAG | 40% | 80% | 61% / 51% | 8.1 সেকেন্ড |
| Pleias-RAG 1B | 38% | 43% | 57% / 73% | 16.9 সেকেন্ড |
| Pleias-RAG 350M | 23% | 39% | 68% / 92% | 6.0 সেকেন্ড |
| তথ্যসূত্র: নিজের তৈরি 320M | 75% | 47% | 9% / 91% | 2.1 সেকেন্ড |
| তথ্যসূত্র: Qwen3.5 0.8B | 75% | 70% | 43% / 21% | 5.1 সেকেন্ড |
| তথ্যসূত্র: Gemma 4 E2B | 85% | 86% | 37% / 32% | 11.1 সেকেন্ড |
উপসংহার হলো, এবারের সমস্যাগুলোতে RAG-নির্দিষ্ট মডেল সাধারণ মডেলের চেয়ে ভালো—এমন কোনো দিক পাওয়া যায়নি।
LFM2-1.2B-RAG: বেশি উত্তর দিতে শিখেছে, কিন্তু মনগড়া উত্তরও বেড়েছে
ইংরেজিতে মূল LFM2-1.2B-এর সঙ্গে তুলনায়, উত্তর থাকা সমস্যায় সঠিকতার হার বেড়েছে (অনুচ্ছেদ 83% → 87%, দীর্ঘ লেখা 78% → 86%)। কিন্তু উত্তরহীন লেখায় মনগড়া উত্তরও বেড়েছে (অনুচ্ছেদ 4% → 10%, দীর্ঘ লেখা 36% → 51%), ফলে সামগ্রিক ফল 81% → 80%—প্রায় একই। মনে হয় RAG-এর জন্য অতিরিক্ত প্রশিক্ষণ এটিকে “যেভাবেই হোক উত্তর দাও” অভিমুখে নিয়ে গেছে।
ক্রোয়েশীয় ভাষায় মূল মডেলটিই প্রায় ব্যবহার অযোগ্য। মূল LFM2-1.2B উত্তর থাকা অনুচ্ছেদের 93%-এ “উত্তর নেই” বলে অস্বীকার করেছে; আর RAG সংস্করণে “Odgovori kratko, jednom rečenicom.(1 বাক্যে সংক্ষেপে উত্তর দাও)” নির্দেশনাটিই হুবহু ফিরিয়ে দেওয়ার মতো উত্তর চোখে পড়েছে। সমর্থিত ভাষার মধ্যে না থাকায়, এটি স্বাভাবিক।
Pleias-RAG: উদ্ধৃতি দেয়, কিন্তু সেই উদ্ধৃতি মূল লেখায় নেই
Pleias উত্তরহীন লেখাতেও প্রায় কখনও অস্বীকার করেনি। ইংরেজিতে, উত্তরহীন অনুচ্ছেদের 78% ও উত্তরহীন দীর্ঘ লেখার 73%-এ উত্তর বানিয়ে বলেছে (1B)।
এদের বিক্রয়-বিন্দু “উদ্ধৃতিসহ উত্তর”-ও সন্দেহজনক। উদ্ধৃতির বাক্যটি মূল লেখায় হুবহু পাওয়া গেছে—এমন অনুপাত গুনে দেখেছি (শুধু ফাঁকা স্থানের পার্থক্য উপেক্ষা করে সম্পূর্ণ মিল দেখা হয়েছে, তাই সামান্য পুনর্লিখিত উদ্ধৃতিও “পাওয়া যায়নি” হিসেবে ধরা হয়েছে)।
| উত্তর থাকা সমস্যা | উত্তরহীন সমস্যা | |
|---|---|---|
| Pleias-RAG 1B (ইংরেজি) | 64% | 42% |
| Pleias-RAG 1B (ক্রোয়েশীয়) | 57% | 53% |
| Pleias-RAG 350M (ইংরেজি) | 66% | 39% |
| Pleias-RAG 350M (ক্রোয়েশীয়) | 52% | 40% |
উদাহরণ হিসেবে, “Tourniquet গানটি প্রথম কোন ব্যান্ড লিখেছিল?” (উত্তর Soul Embraced)।
- উত্তরহীন অনুচ্ছেদ দিলে, 1B উত্তর দিয়েছে “Amy Lee লিখেছিলেন”, এবং “Amy Lee (born Amy Leigh Lee, November 1, 1970) ...” নামে মূল লেখায় নেই এমন একটি বাক্যকে উদ্ধৃতি হিসেবে দিয়েছে
- উত্তর থাকা অনুচ্ছেদ দিলেও এটি উত্তর দিয়েছে “Amy Lee লিখেছিলেন”। উপরন্তু, সংযুক্ত উদ্ধৃতিটি ছিল “originally written ... for the Christian death metal band Soul Embraced”—অর্থাৎ উদ্ধৃতিটি সঠিক হলেও উত্তরটি তার সঙ্গে সাংঘর্ষিক
উদ্ধৃতি থাকলে উত্তরটি “সত্যিই মূল লেখাভিত্তিক” বলে মনে হয়, তাই বরং এটি বিপজ্জনক।
গতির দিক থেকেও Pleias উত্তরের আগে বিশ্লেষণ লেখে বলে উত্তর দীর্ঘ হয় (দীর্ঘ লেখায় গড়ে 381–420 টোকেন)। 1B একটি দীর্ঘ প্রশ্নে 16.9 সেকেন্ড নেয়, যা Gemma 4 E2B (11.1 সেকেন্ড)-এর চেয়েও ধীর। তাছাড়া ক্রোয়েশীয় দীর্ঘ লেখার 25% প্রসঙ্গে ঢোকেনি (ভুল হিসেবে গণনা করা হয়েছে; সময় কেবল ঢোকা সমস্যাগুলোর গড়, তাই বাস্তবে আরও কিছুটা সময় লাগবে)।
কেন এমন হলো? (অনুমান)
- ভাষা: তিনটির কোনোটিই ক্রোয়েশীয়কে সমর্থিত ভাষার তালিকায় রাখে না। তবে ইংরেজিতেও তারা সাধারণ মডেলের কাছে হেরেছে
- সমস্যার ধরন: এবার ছিল “একটি লেখা থেকে সংক্ষেপে উত্তর দাও / উত্তর না থাকলে অস্বীকার করো” ধরনের সমস্যা। Pleias একাধিক উপকরণ মিলিয়ে উত্তর দেওয়া সমস্যা (যেমন HotpotQA)-তে মূল্যায়িত হয়েছে, তাই শক্তির ক্ষেত্র আলাদা হতে পারে
- অস্বীকারের পদ্ধতি: সাধারণ মডেলকে “উত্তর না থাকলে এভাবে উত্তর দাও” বলা যায়, কিন্তু Pleias-কে নির্দেশনা দেওয়ার কোনো জায়গা নেই। মডেলটির নিজের “এই উপকরণ থেকে উত্তর দেওয়া যায় না” নির্ধারণের ব্যবস্থা আছে, কিন্তু এবার তা খুব একটা কাজ করেনি
সংযোজনের সারাংশ
- শুধু “RAG-নির্দিষ্ট” নাম দেখে বেছে না নেওয়াই ভালো। এবারের শর্তে Gemma 4 E2B বা Qwen3.5-এর মতো সাধারণ নির্দেশনা-ভিত্তিক মডেলই বেশি নির্ভুল ছিল এবং যেখানে অস্বীকার করা উচিত, সেখানে অস্বীকার করেছে
- উদ্ধৃতিসহ উত্তরের অর্থ নেই, যদি উদ্ধৃতিটিই যাচাই না করা হয়। Pleias-এর মাত্র 4–7 ভাগ উদ্ধৃতি মূল লেখায় হুবহু পাওয়া গেছে
- নিজের তৈরি মডেল একই আকারের RAG-নির্দিষ্ট মডেলের চেয়ে ভালো। Pleias-RAG 350M-এর সঙ্গে তুলনায়, ক্রোয়েশীয়ে সামগ্রিক ফল 75% বনাম 23%, আর একটি দীর্ঘ প্রশ্নের সময় 2.1 সেকেন্ড বনাম 6.0 সেকেন্ড। ক্রোয়েশীয়-নির্দিষ্টভাবে বানানোর মূল্য ছিল
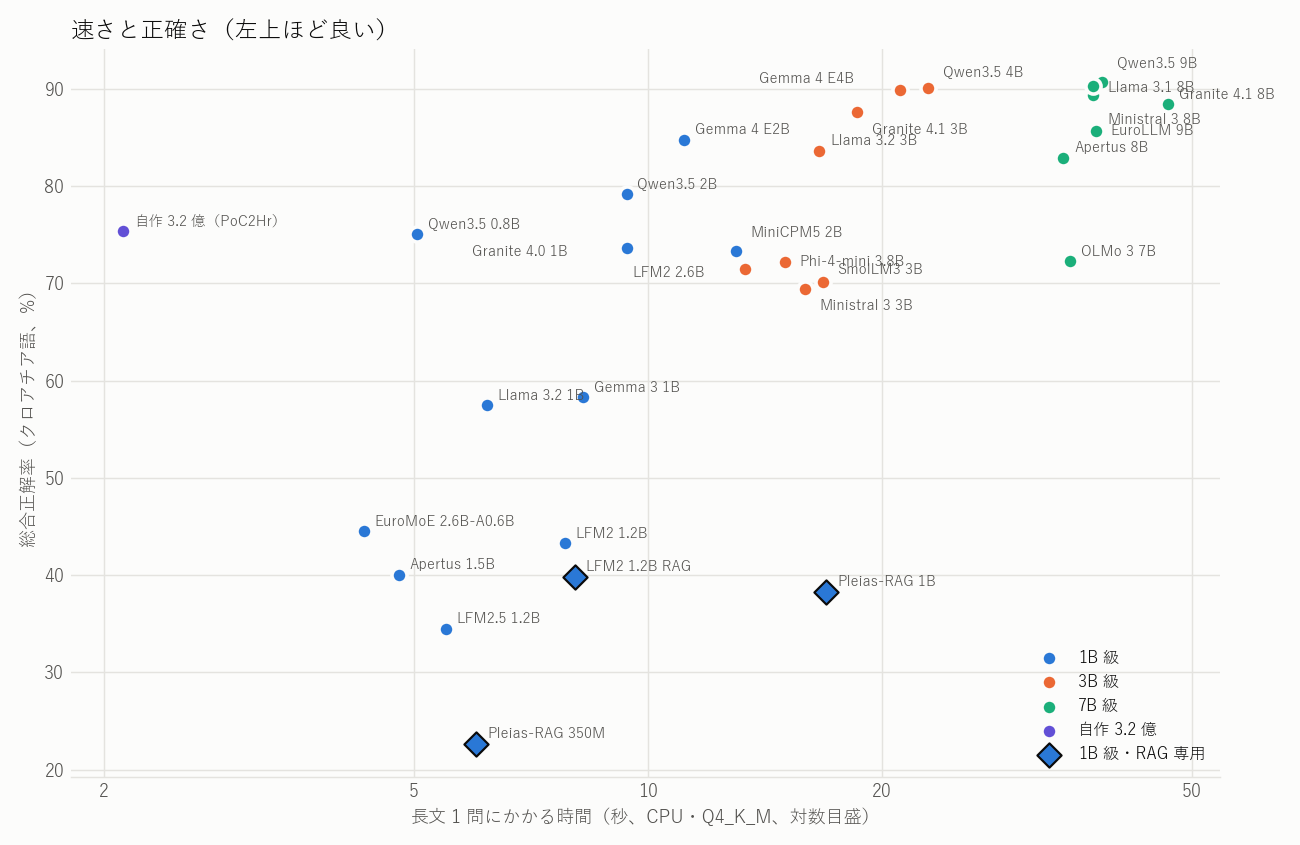
যোগ করা 4টি মডেলের গতি একই দিনের রাতে একই PC-তে একই শর্তে মাপা হয়েছে। গতি ও নির্ভুলতার চিত্রেও এগুলো যোগ করা হয়েছে।
সব ফলাফল
ক্রোয়েশীয়
| মডেল | শ্রেণি | অনুচ্ছেদে সঠিক | দীর্ঘ লেখায় সঠিক | সামগ্রিক | উত্তর না থাকলেও বানানো উত্তর (অনুচ্ছেদ/দীর্ঘ লেখা) | উত্তরগুলোর মধ্যে সঠিকের হার |
|---|---|---|---|---|---|---|
| Qwen3.5 9B | 7B শ্রেণি | 84% | 90% | 91% | 1% / 10% | 91% |
| Llama 3.1 8B | 7B শ্রেণি | 88% | 88% | 90% | 2% / 15% | 90% |
| Qwen3.5 4B | 3B শ্রেণি | 82% | 88% | 90% | 1% / 9% | 92% |
| Gemma 4 E4B | 3B শ্রেণি | 87% | 91% | 90% | 2% / 19% | 87% |
| Ministral 3 8B | 7B শ্রেণি | 88% | 85% | 89% | 3% / 14% | 89% |
| Granite 4.1 8B | 7B শ্রেণি | 91% | 90% | 88% | 2% / 30% | 84% |
| Granite 4.1 3B | 3B শ্রেণি | 88% | 88% | 88% | 2% / 29% | 83% |
| EuroLLM 9B | 7B শ্রেণি | 87% | 75% | 86% | 5% / 14% | 88% |
| Gemma 4 E2B | 1B শ্রেণি | 88% | 88% | 85% | 5% / 37% | 78% |
| Llama 3.2 3B | 3B শ্রেণি | 80% | 81% | 84% | 2% / 27% | 81% |
| Apertus 8B | 7B শ্রেণি | 85% | 80% | 83% | 8% / 29% | 81% |
| Qwen3.5 2B | 1B শ্রেণি | 74% | 74% | 79% | 4% / 29% | 79% |
| নিজস্ব 320 মিলিয়ন | নিজস্ব | 72% | 46% | 75% | 3% / 9% | 72% |
| Qwen3.5 0.8B | 1B শ্রেণি | 74% | 75% | 75% | 11% / 43% | 68% |
| Granite 4.0 1B | 1B শ্রেণি | 83% | 77% | 74% | 22% / 51% | 64% |
| MiniCPM5 2B | 1B শ্রেণি | 62% | 44% | 73% | 1% / 6% | 89% |
| OLMo 3 7B | 7B শ্রেণি | 80% | 70% | 72% | 7% / 64% | 62% |
| Phi-4-mini 3.8B | 3B শ্রেণি | 91% | 89% | 72% | 38% / 64% | 64% |
| LFM2 2.6B | 3B শ্রেণি | 69% | 61% | 71% | 5% / 43% | 62% |
| SmolLM3 3B | 3B শ্রেণি | 83% | 78% | 70% | 20% / 73% | 62% |
| Ministral 3 3B | 3B শ্রেণি | 64% | 28% | 69% | 2% / 5% | 90% |
| Gemma 3 1B | 1B শ্রেণি | 79% | 62% | 58% | 32% / 89% | 48% |
| Llama 3.2 1B | 1B শ্রেণি | 73% | 35% | 57% | 43% / 33% | 48% |
| EuroMoE 2.6B-A0.6B | 1B শ্রেণি | 73% | 67% | 45% | 80% / 94% | 42% |
| LFM2 1.2B | 1B শ্রেণি | 5% | 15% | 43% | 1% / 42% | 21% |
| Apertus 1.5B | 1B শ্রেণি | 88% | 58% | 40% | 99% / 75% | 44% |
| LFM2 1.2B RAG | 1B শ্রেণি・শুধু RAG-এর জন্য | 23% | 25% | 40% | 28% / 61% | 24% |
| Pleias-RAG 1B | 1B শ্রেণি・শুধু RAG-এর জন্য | 73% | 18% | 38% | 63% / 57% | 35% |
| LFM2.5 1.2B | 1B শ্রেণি | 45% | 18% | 34% | 53% / 75% | 23% |
| Pleias-RAG 350M | 1B শ্রেণি・শুধু RAG-এর জন্য | 54% | 9% | 23% | 85% / 68% | 21% |
ইংরেজি
| মডেল | শ্রেণি | অনুচ্ছেদে সঠিক | দীর্ঘ লেখায় সঠিক | সামগ্রিক | উত্তর না থাকলেও বানানো উত্তর (অনুচ্ছেদ/দীর্ঘ লেখা) | উত্তরগুলোর মধ্যে সঠিকের হার |
|---|---|---|---|---|---|---|
| Gemma 4 E4B | 3B শ্রেণি | 86% | 87% | 88% | 3% / 18% | 85% |
| Granite 4.1 8B | 7B শ্রেণি | 85% | 78% | 87% | 3% / 15% | 89% |
| Gemma 4 E2B | 1B শ্রেণি | 87% | 88% | 86% | 6% / 32% | 79% |
| Llama 3.1 8B | 7B শ্রেণি | 78% | 77% | 85% | 2% / 11% | 89% |
| Phi-4-mini 3.8B | 3B শ্রেণি | 87% | 90% | 85% | 10% / 31% | 80% |
| Llama 3.2 3B | 3B শ্রেণি | 78% | 82% | 85% | 2% / 20% | 85% |
| LFM2 2.6B | 3B শ্রেণি | 77% | 76% | 84% | 2% / 13% | 88% |
| Qwen3.5 9B | 7B শ্রেণি | 69% | 80% | 84% | 1% / 9% | 92% |
| Granite 4.0 1B | 1B শ্রেণি | 87% | 77% | 83% | 6% / 29% | 81% |
| Ministral 3 8B | 7B শ্রেণি | 78% | 63% | 82% | 2% / 8% | 91% |
| Qwen3.5 4B | 3B শ্রেণি | 63% | 77% | 82% | 1% / 8% | 92% |
| EuroLLM 9B | 7B শ্রেণি | 83% | 58% | 81% | 3% / 10% | 90% |
| Granite 4.1 3B | 3B শ্রেণি | 80% | 57% | 81% | 1% / 10% | 90% |
| LFM2 1.2B | 1B শ্রেণি | 83% | 78% | 81% | 4% / 36% | 76% |
| LFM2 1.2B RAG | 1B শ্রেণি・শুধু RAG-এর জন্য | 87% | 86% | 80% | 10% / 51% | 73% |
| SmolLM3 3B | 3B শ্রেণি | 90% | 85% | 79% | 16% / 52% | 71% |
| Apertus 8B | 7B শ্রেণি | 78% | 82% | 78% | 7% / 47% | 73% |
| Qwen3.5 2B | 1B শ্রেণি | 58% | 52% | 73% | 2% / 11% | 87% |
| OLMo 3 7B | 7B শ্রেণি | 52% | 47% | 71% | 0% / 8% | 90% |
| Gemma 3 1B | 1B শ্রেণি | 77% | 66% | 71% | 11% / 57% | 62% |
| Qwen3.5 0.8B | 1B শ্রেণি | 48% | 56% | 70% | 2% / 21% | 77% |
| Ministral 3 3B | 3B শ্রেণি | 53% | 30% | 67% | 1% / 6% | 90% |
| Llama 3.2 1B | 1B শ্রেণি | 57% | 35% | 65% | 9% / 16% | 73% |
| LFM2.5 1.2B | 1B শ্রেণি | 39% | 24% | 61% | 1% / 9% | 76% |
| MiniCPM5 2B | 1B শ্রেণি | 28% | 25% | 60% | 0% / 3% | 92% |
| EuroMoE 2.6B-A0.6B | 1B শ্রেণি | 57% | 52% | 55% | 27% / 66% | 53% |
| Apertus 1.5B | 1B শ্রেণি | 89% | 79% | 48% | 93% / 97% | 47% |
| নিজস্ব 320 মিলিয়ন | নিজস্ব | 73% | 53% | 47% | 55% / 91% | 40% |
| Pleias-RAG 1B | 1B শ্রেণি・শুধু RAG-এর জন্য | 75% | 44% | 43% | 78% / 73% | 40% |
| Pleias-RAG 350M | 1B শ্রেণি・শুধু RAG-এর জন্য | 63% | 44% | 39% | 67% / 92% | 34% |
CPU-তে গতি(i7-13700K・llama.cpp Q4_K_M)
| মডেল | আকার | জেনারেশন (টোকেন/সেকেন্ড) | পড়া (টোকেন/সেকেন্ড) | দীর্ঘ লেখার ইনপুট টোকেনসংখ্যা | দীর্ঘ লেখা ১ প্রশ্নের সময় |
|---|---|---|---|---|---|
| নিজস্ব 320 মিলিয়ন | 193 MB | 90.8 | 1,528 | 2,443 | 2.1 সেকেন্ড |
| EuroMoE 2.6B-A0.6B | 1,541 MB | 65.6 | 778 | 2,920 | 4.3 সেকেন্ড |
| Apertus 1.5B | 935 MB | 28.3 | 634 | 2,810 ※ | 4.8 সেকেন্ড |
| Qwen3.5 0.8B | 517 MB | 35.9 | 742 | 3,258 | 5.1 সেকেন্ড |
| LFM2.5 1.2B | 697 MB | 33.2 | 673 | 3,468 | 5.5 সেকেন্ড |
| Pleias-RAG 350M | 219 MB | 97.2 | 1,685 | 2,853 ※ | 6.0 সেকেন্ড |
| Llama 3.2 1B | 770 MB | 26.7 | 636 | 3,511 | 6.2 সেকেন্ড |
| LFM2 1.2B | 697 MB | 31.4 | 675 | 3,468 | 7.8 সেকেন্ড |
| LFM2 1.2B RAG | 697 MB | 32.8 | 678 | 3,468 | 8.1 সেকেন্ড |
| Gemma 3 1B | 769 MB | 29.6 | 398 | 3,055 | 8.2 সেকেন্ড |
| Qwen3.5 2B | 1,251 MB | 16.4 | 415 | 3,258 | 9.4 সেকেন্ড |
| Granite 4.0 1B | 976 MB | 22.9 | 414 | 3,636 | 9.4 সেকেন্ড |
| Gemma 4 E2B | 3,257 MB | 16.0 | 329 | 3,055 | 11.1 সেকেন্ড |
| MiniCPM5 2B | 1,489 MB | 16.7 | 313 | 3,796 | 13.0 সেকেন্ড |
| LFM2 2.6B | 1,491 MB | 14.5 | 278 | 3,468 | 13.3 সেকেন্ড |
| Phi-4-mini 3.8B | 2,378 MB | 9.9 | 208 | 2,974 | 15.0 সেকেন্ড |
| Ministral 3 3B | 2,048 MB | 9.5 | 215 | 3,100 | 15.9 সেকেন্ড |
| Llama 3.2 3B | 1,926 MB | 12.0 | 237 | 3,511 | 16.6 সেকেন্ড |
| SmolLM3 3B | 1,827 MB | 12.7 | 238 | 3,544 | 16.8 সেকেন্ড |
| Pleias-RAG 1B | 710 MB | 31.6 | 583 | 2,853 ※ | 16.9 সেকেন্ড |
| Granite 4.1 3B | 2,002 MB | 11.4 | 202 | 3,614 | 18.6 সেকেন্ড |
| Gemma 4 E4B | 5,064 MB | 8.1 | 171 | 3,055 | 21.1 সেকেন্ড |
| Qwen3.5 4B | 2,655 MB | 7.6 | 166 | 3,258 | 22.9 সেকেন্ড |
| Apertus 8B | 4,824 MB | 5.1 | 102 | 3,158 | 34.2 সেকেন্ড |
| OLMo 3 7B | 4,264 MB | 5.8 | 108 | 3,642 | 34.9 সেকেন্ড |
| Llama 3.1 8B | 4,693 MB | 5.3 | 101 | 3,511 | 37.3 সেকেন্ড |
| Ministral 3 8B | 4,958 MB | 5.0 | 95 | 3,100 | 37.4 সেকেন্ড |
| EuroLLM 9B | 5,324 MB | 4.7 | 86 | 2,920 | 37.6 সেকেন্ড |
| Qwen3.5 9B | 5,512 MB | 4.5 | 101 | 3,258 | 38.4 সেকেন্ড |
| Granite 4.1 8B | 5,100 MB | 4.8 | 88 | 3,614 | 46.6 সেকেন্ড |
※ Apertus 1.5B এবং Pleias-RAG-এর ক্ষেত্রে, কেবল 4,096 টোকেনের প্রসঙ্গে ধরে এমন দীর্ঘ লেখাগুলোর গড়।