নিজের তৈরি ৩০ কোটি প্যারামিটারের LLM কোয়ান্টাইজ করে CPU-তে গতি ও নির্ভুলতা তুলনা করে দেখলাম
আগের নিবন্ধে তৈরি করা ক্রোয়েশীয় RAG-এর জন্য ৩.২ কোটি প্যারামিটারের মডেলটি। CPU-তে চালানোর জন্যই বানানো, তাই এবার এটিকে কোয়ান্টাইজ করে দেখলাম কতটা ছোট ও দ্রুত করা যায়, আর নির্ভুলতা কতটা কমে।
আগে উপসংহার বলি।
- Q6_K-ই ঠিকঠাক। আকার ১/৫ (254MB), জেনারেশন প্রায় ৪ গুণ দ্রুত, নির্ভুলতা মূল মডেলের সমান
- Q2_K নষ্ট হয়ে যায়। দ্রুত, কিন্তু উত্তর থাকা প্রশ্নেও বলতে শুরু করে, “কোনো উত্তর নেই”
- অপ্রত্যাশিতভাবে, Q4_K_M-এর চেয়ে Q3_K_M বেশি নির্ভুল ছিল
যা করেছি
PyTorch-এ তৈরি মডেলটিকে CPU ইনফারেন্সে বহুল ব্যবহৃত llama.cpp-এ চালানো যায় এমন ফরম্যাটে (GGUF) রূপান্তর করেছি এবং ৮ ধরনের প্রিসিশনে সংরক্ষণ করেছি।
- মডেলটি Qwen3-এর একই ফরম্যাটে এক্সপোর্ট করে GGUF-এ রূপান্তর করেছি
- টোকেনাইজারটি নিজের তৈরি হওয়ায় llama.cpp এটিকে “অপরিচিত টোকেনাইজার” বলে রূপান্তর করতে অস্বীকার করেছিল। শব্দ আলাদা করার নিয়ম তুলনা করে দেখি, সেটি Qwen2-এর সঙ্গে হুবহু এক; তাই Qwen2 হিসেবে নিবন্ধন করে কাজটি সম্পন্ন করেছি
- রূপান্তরটি সঠিক কি না যাচাই করেছি। ১৬০টি লেখার টোকেন বিভাজন PyTorch সংস্করণের সঙ্গে পুরোপুরি মিলে গেছে। ২০টি প্রশ্নে প্রতিবার সর্বোচ্চ সম্ভাবনার শব্দ বেছে নিয়ে জেনারেশন করালে, ২০টিরই আউটপুট সম্পূর্ণ এক ছিল
llama-quantizeদিয়ে F16 থেকে Q2_K তৈরি করেছি
অতএব, টেবিলের F32-এর ভেতরের বিষয়বস্তু PyTorch সংস্করণের মতোই। এটিই তুলনার ভিত্তি।
মাপার পদ্ধতি
- CPU হলো i7-13700K। GPU ব্যবহার করিনি
- llama.cpp-এর সেটিং: জেনারেশনে ৮ থ্রেড, লেখা পড়তে ১৬ থ্রেড (পরীক্ষা করে দেখেছি, এটিই সবচেয়ে দ্রুত)
- মূল্যায়নের ১০০টি প্রশ্ন × ৪ ধরনের প্রসঙ্গ দিয়ে প্রতিটি মডেলকে ৪০০ বার করে উত্তর দিতে দিয়েছি
- অনুচ্ছেদ: উত্তর থাকা প্রায় ১০০ টোকেনের অনুচ্ছেদ
- দীর্ঘ লেখা: উত্তর থাকা প্রায় ৩,০০০ টোকেনের লেখা (এর সঙ্গে অপ্রাসঙ্গিক নিবন্ধও মেশানো ছিল)
- উত্তর নেই (অনুচ্ছেদ・দীর্ঘ লেখা): যে লেখায় উত্তর নেই। প্রত্যাখ্যান করতে পারলে সেটিই সঠিক
- আগের নিবন্ধে ৩০০টি প্রশ্নে মাপা হয়েছিল, তাই সংখ্যাগুলো সামান্য ভিন্ন
ফলাফল: নির্ভুলতা
| ফরম্যাট | আকার | অনুচ্ছেদ সঠিক | দীর্ঘ লেখায় সঠিক | দীর্ঘ লেখা প্রত্যাখ্যান | মনগড়া উত্তর (উত্তর নেই: অনুচ্ছেদ/দীর্ঘ লেখা) | যাচাই-পরবর্তী নির্ভুলতা |
|---|---|---|---|---|---|---|
| F32(ভিত্তি) | 1,233MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| F16 | 617MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| Q8_0 | 329MB | 76% | 53% | 30% | 1% / 8% | 81.9% |
| Q6_K | 254MB | 79% | 54% | 30% | 2% / 9% | 81.3% |
| Q5_K_M | 223MB | 72% | 45% | 41% | 1% / 6% | 84.4% |
| Q4_K_M | 193MB | 68% | 37% | 46% | 1% / 7% | 75.9% |
| Q3_K_M | 160MB | 72% | 48% | 38% | 1% / 8% | 80.4% |
| Q2_K | 129MB | 39% | 11% | 78% | 4% / 7% | 72.2% |
“যাচাই-পরবর্তী নির্ভুলতা” হলো মডেলের উদ্ধৃতি সত্যিই লেখাটির মধ্যে আছে কি না প্রোগ্রাম দিয়ে যাচাই করে, না থাকলে সেটিকে “উত্তর নেই” দিয়ে বদলে দেওয়ার পর উত্তর দেওয়া ক্ষেত্রগুলোর মধ্যে সঠিক উত্তরের হার।
- F16・Q8_0・Q6_K ভিত্তির সঙ্গে প্রায় একই। পার্থক্য মাত্র ১–২টি প্রশ্ন
- Q5_K_M থেকে নিচে ভুল বাড়ার চেয়ে “প্রত্যাখ্যান” বাড়ে। আত্মবিশ্বাস কমলে প্রত্যাখ্যান করে—আগেরবার শেখানো এই স্বভাবটাই যেন 그대로 দেখা যাচ্ছে। মনগড়া উত্তর বাড়েনি
- Q4_K_M, Q3_K_M-এর চেয়ে খারাপ। দীর্ঘ লেখায় 37% বনাম 48%। ১০০টি প্রশ্নে কিছুটা ওঠানামা হবেই, তবে ১১ পয়েন্ট বড় পার্থক্য। কারণ এখনো খতিয়ে দেখিনি
- Q2_K দীর্ঘ লেখার 78% প্রত্যাখ্যান করে। এটি যেন আরেকটি মডেল
ফলাফল: গতি
| ফরম্যাট | জেনারেশনের গতি | প্রতি রানের গড় সময় |
|---|---|---|
| PyTorch fp32(তথ্যসূত্র) | অনুচ্ছেদ 14.6・দীর্ঘ লেখা 6.7 tok/s | — |
| F32 | 18.7 tok/s | 2.76 সেকেন্ড |
| F16 | 35.9 tok/s | 2.08 সেকেন্ড |
| Q8_0 | 59.0 tok/s | 1.93 সেকেন্ড |
| Q6_K | 73.1 tok/s | 1.33 সেকেন্ড |
| Q5_K_M | 81.2 tok/s | 1.26 সেকেন্ড |
| Q4_K_M | 89.1 tok/s | 1.10 সেকেন্ড |
| Q3_K_M | 103.4 tok/s | 1.12 সেকেন্ড |
| Q2_K | 119.9 tok/s | 1.07 সেকেন্ড |
llama.cpp-এর সংখ্যাগুলো ৪০০ রানের গড় (অনুচ্ছেদ・দীর্ঘ লেখা・উত্তর নেই—সব মিলিয়ে)। PyTorch-এর সংখ্যাগুলো আগের নিবন্ধে মাপা।
- জেনারেশনের গতি প্রায় আকারের ব্যস্তানুপাতিক। CPU-তে হিসাবের চেয়ে মেমরি থেকে ওজন পড়ার গতি বেশি নির্ধারক, তাই যত ছোট তত দ্রুত
- একই F32 হলেও, llama.cpp PyTorch-এর চেয়ে দ্রুত
- তবে Q6_K থেকে নিচে প্রতি রানের সময় খুব বেশি কমে না। এই দৈর্ঘ্যে শুরুর দিকে লেখা পড়ে নেওয়ার সময়টাই বেশি হয়ে যায়
ভিডিও: একই দীর্ঘ লেখার প্রশ্ন CPU-তে সমাধান করিয়ে দেখলাম
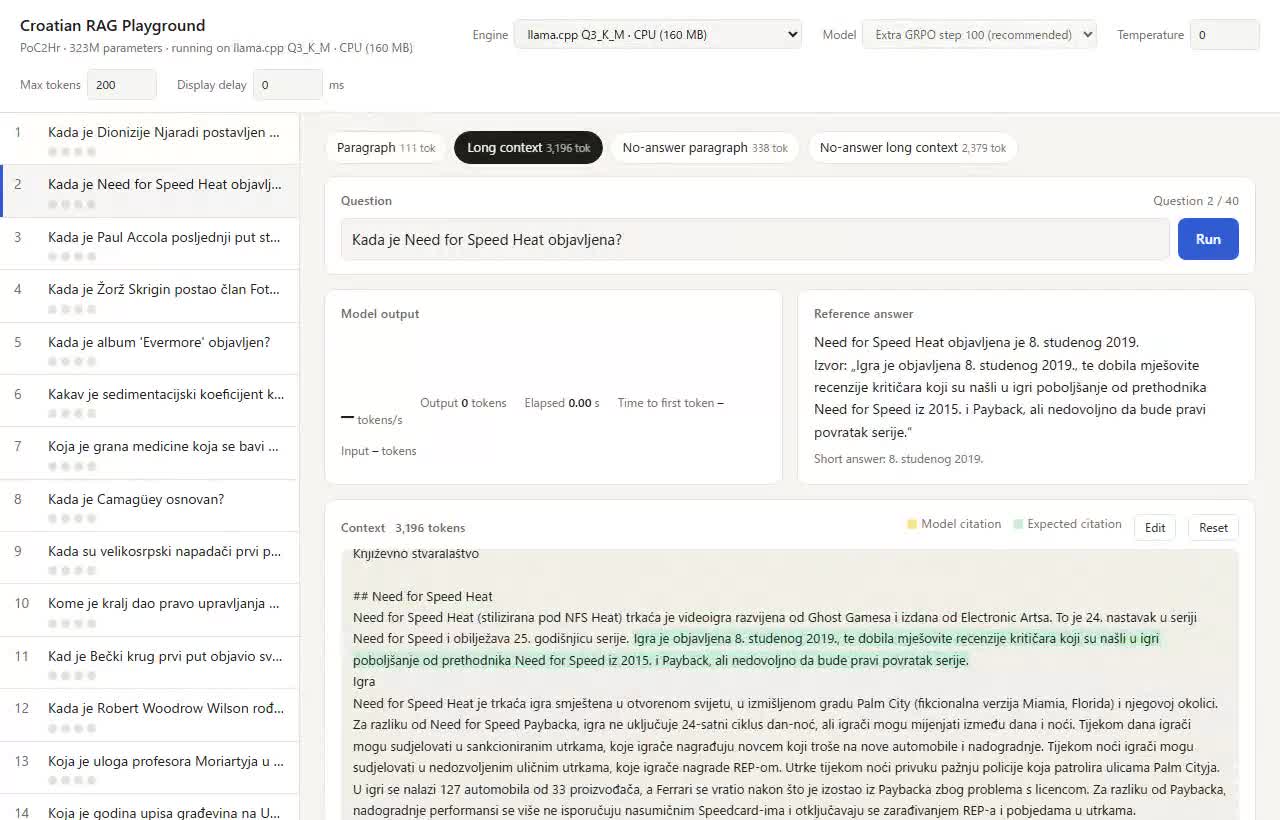
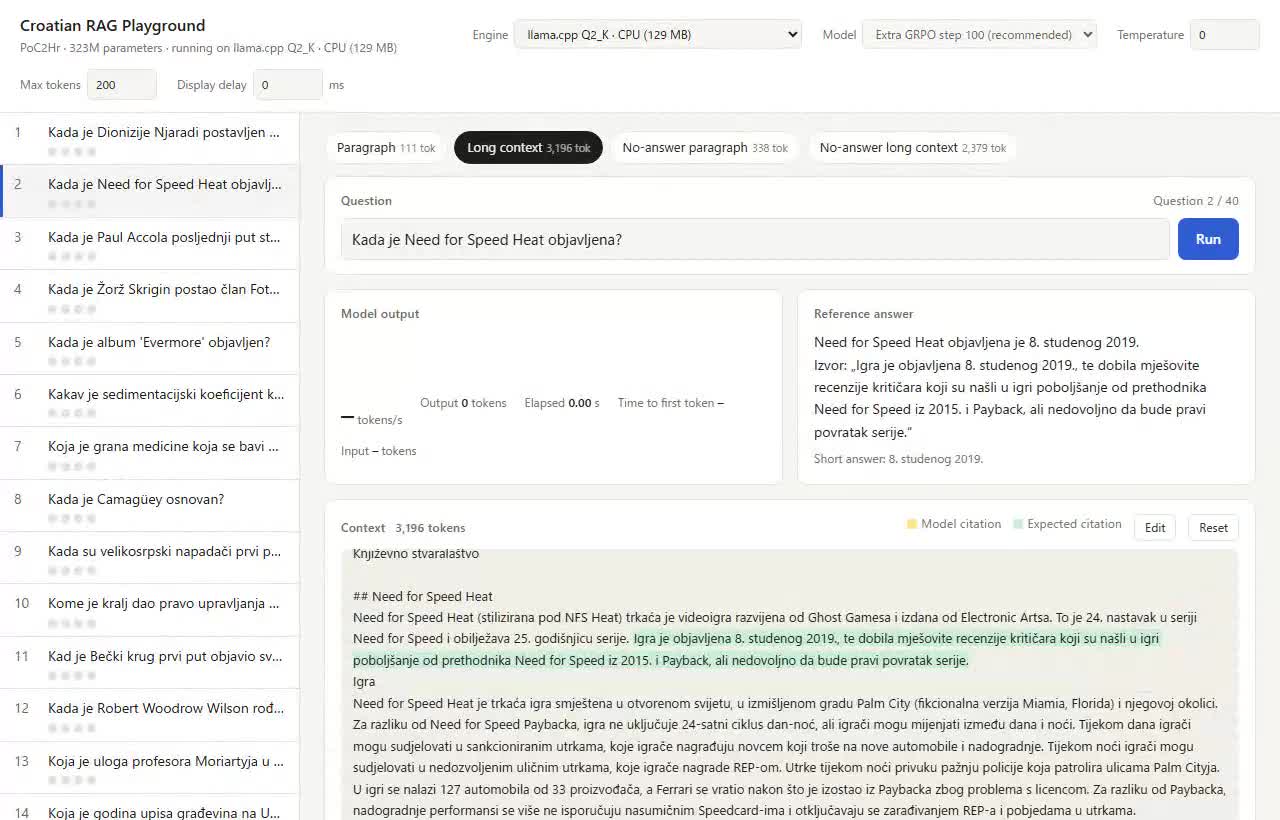
প্রায় ৩,২০০ টোকেনের একটি লেখা দিয়ে জিজ্ঞেস করেছি, “Need for Speed Heat কবে মুক্তি পেয়েছিল?” সঠিক উত্তর ৮ নভেম্বর ২০১৯।
রেকর্ড করার সময়, এবং ব্রাউজারে স্ক্রিন আঁকতে আঁকতে চালানো হয়েছে বলে ভিডিওর গতি উপরের টেবিলের চেয়ে কিছুটা কম। পাশাপাশি তুলনা করার জন্য দেখুন।
| ফরম্যাট | ভিডিওতে জেনারেশনের গতি | প্রথম অক্ষর আসতে | মোট | ফলাফল |
|---|---|---|---|---|
| PyTorch fp32 | 5.5 tok/s | 4.8 সেকেন্ড | 18.5 সেকেন্ড | সঠিক |
| F32 | 14.2 tok/s | 2.8 সেকেন্ড | 8.1 সেকেন্ড | সঠিক |
| F16 | 25.9 tok/s | 3.5 সেকেন্ড | 6.4 সেকেন্ড | সঠিক |
| Q8_0 | 38.2 tok/s | 4.0 সেকেন্ড | 5.9 সেকেন্ড | সঠিক |
| Q6_K | 41.6 tok/s | 2.6 সেকেন্ড | 4.4 সেকেন্ড | সঠিক |
| Q5_K_M | 46.3 tok/s | 2.6 সেকেন্ড | 4.3 সেকেন্ড | সঠিক |
| Q4_K_M | 47.2 tok/s | 2.3 সেকেন্ড | 4.7 সেকেন্ড | সঠিক(উত্তর কিছুটা দীর্ঘ) |
| Q3_K_M | 56.7 tok/s | 2.5 সেকেন্ড | 4.5 সেকেন্ড | সঠিক(উত্তর কিছুটা দীর্ঘ) |
| Q2_K | 61.3 tok/s | 2.7 সেকেন্ড | 2.8 সেকেন্ড | প্রত্যাখ্যান করেছে |
F32 থেকে Q5_K_M পর্যন্ত উত্তর ও উদ্ধৃতি PyTorch সংস্করণের সঙ্গে হুবহু এক। Q4_K_M ও Q3_K_M-এ উত্তরের বাক্য দীর্ঘ হয়েছে, তবে উদ্ধৃতি সঠিক ছিল। Q2_K উত্তর থাকা সত্ত্বেও বলেছে, “মূল লেখায় কোনো উত্তর নেই।”
PyTorch fp32(মূল মডেল)
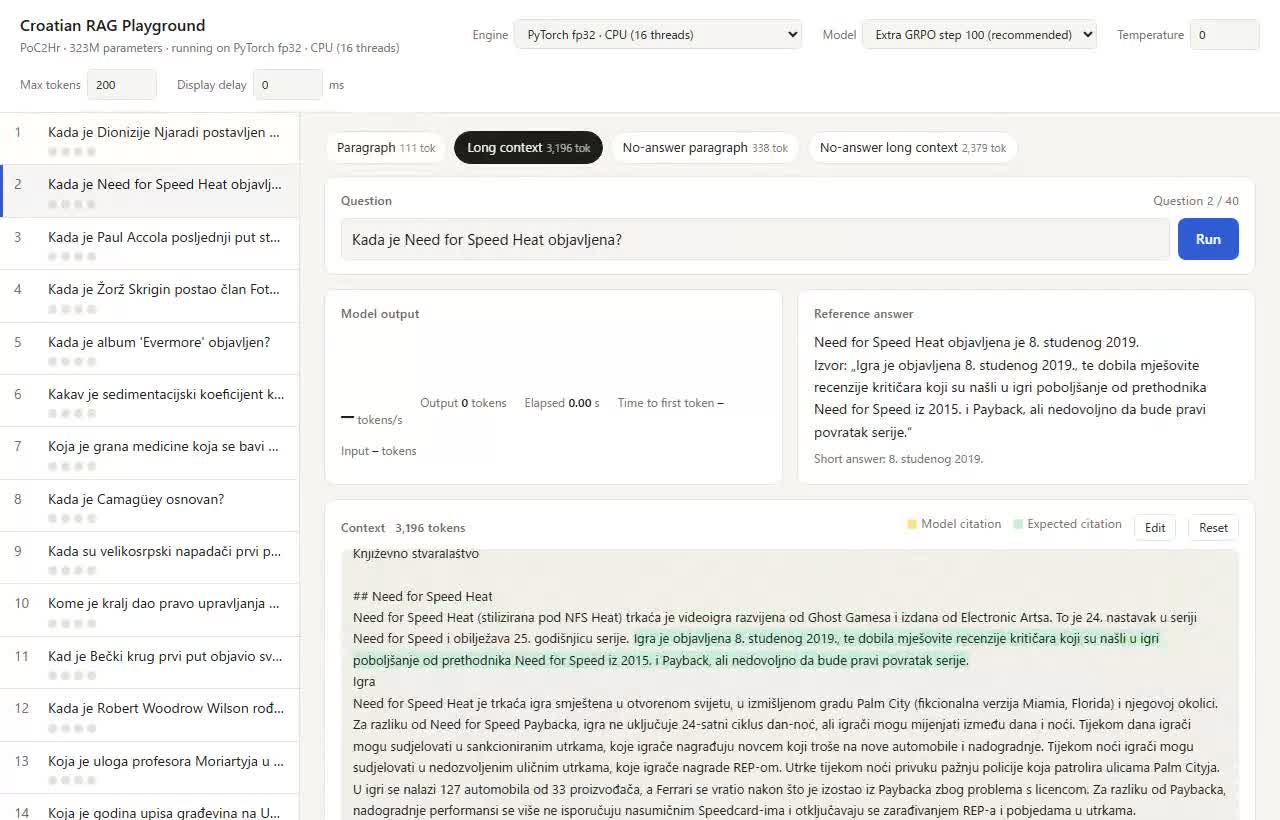
llama.cpp F32(1,233MB)
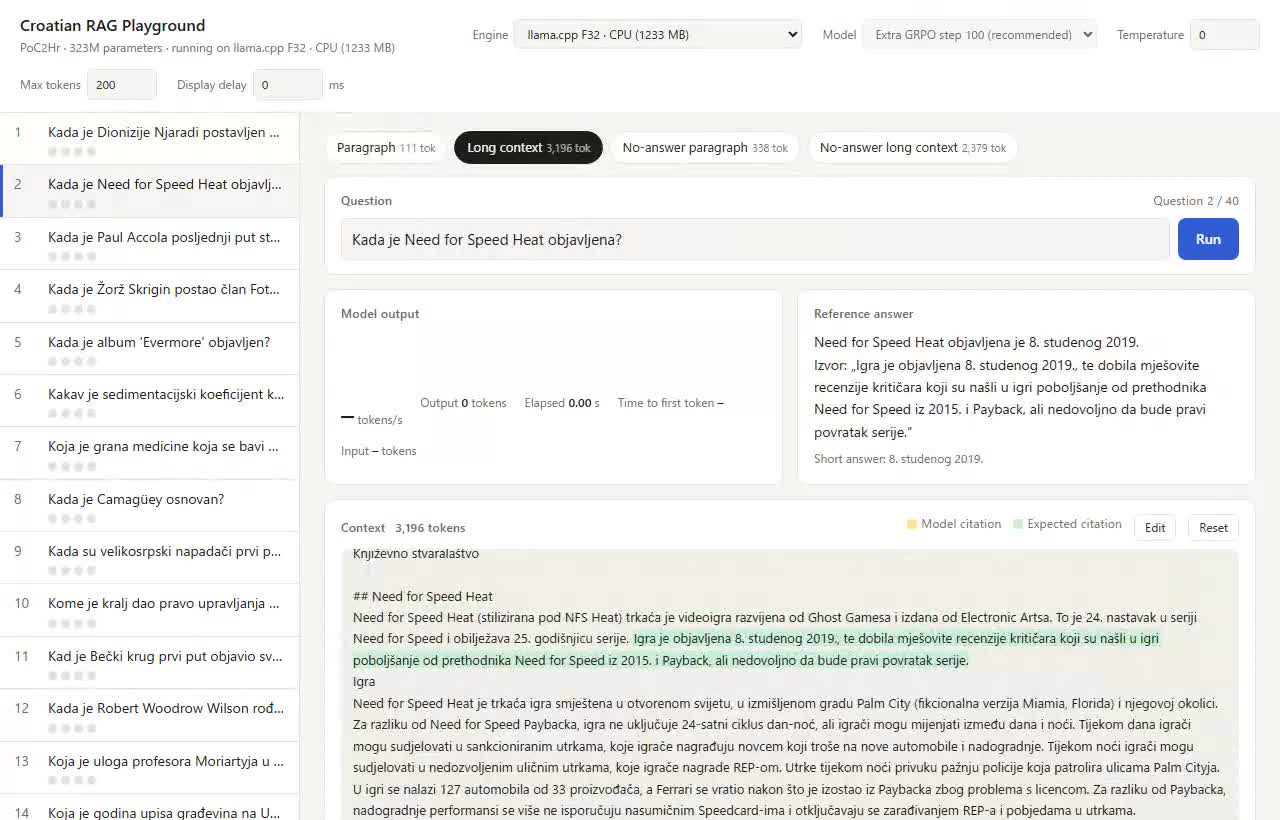
llama.cpp F16(617MB)
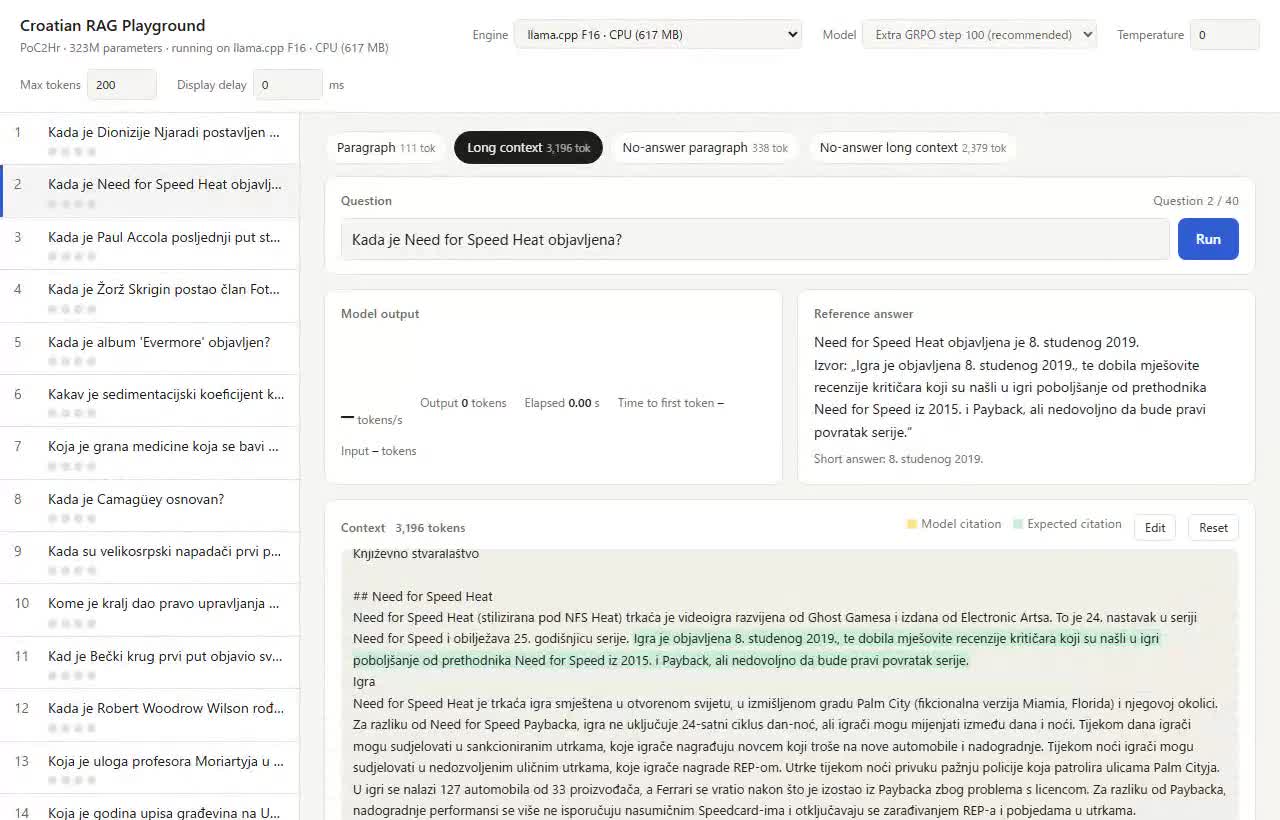
llama.cpp Q8_0(329MB)
llama.cpp Q6_K(254MB)
llama.cpp Q5_K_M(223MB)
llama.cpp Q4_K_M(193MB)
llama.cpp Q3_K_M(160MB)
llama.cpp Q2_K(129MB)
বিশ্লেষণ
- এই মডেলটি CPU-তে চালাতে হলে Q6_K। নির্ভুলতা মূলটির মতোই, আকার ১/৫, জেনারেশন PyTorch-এর প্রায় ৫ গুণ দ্রুত। দ্বিধার কোনো কারণ নেই
- নিশ্চিন্ত থাকতে চাইলে Q8_0। মূলটির প্রায় সমান, 329MB। তবু যথেষ্ট ছোট
- ৩০ কোটি প্যারামিটারের ছোট মডেল কোয়ান্টাইজেশনে দুর্বল। বড় মডেলে Q4-তেও প্রায় অবনতি হয় না বলা হলেও, এখানে Q5 থেকেই চোখে পড়ার মতো কমেছে। মডেলটিতে শুরু থেকেই বাড়তি সক্ষমতা কম ছিল, তাই কাটছাঁটের প্রভাব বেশি
- নষ্ট হওয়ার ধরনটি “প্রত্যাখ্যান” হওয়া ভালো। মনগড়া উত্তর বাড়ার চেয়ে প্রত্যাখ্যান করা RAG-এর জন্য নিরাপদ। আগেরবার রিইনফোর্সমেন্ট লার্নিং দিয়ে কীভাবে প্রত্যাখ্যান করতে হয় শেখানোর ফল এখানেও দেখা যাচ্ছে
- ছোট মডেলে গতির পার্থক্য কমে আসে। Q6_K থেকে নিচে জেনারেশন দ্রুত হলেও লেখা পড়ার সময় থেকেই যায়, তাই অনুভূত পার্থক্য কম। ভিডিওতেও Q6_K থেকে Q3_K_M ৪ সেকেন্ডের ঘরেই আছে
- Q4_K_M কেন Q3_K_M-এর কাছে হেরেছে, তার কারণ এখনো অজানা। প্রশ্নের সংখ্যা বাড়িয়ে কিংবা কোন স্তর কীভাবে কোয়ান্টাইজ হচ্ছে তা দেখে তদন্ত করতে চাই