একটি RTX 4090 দিয়েই শূন্য থেকে GPT-2 বানালাম: এক দিনে মূল মডেলকে ছাড়াল, চ্যাটও করতে পারে
বাড়ির একটি RTX 4090 দিয়েই GPT-2 (124M) শূন্য থেকে প্রশিক্ষণ দিয়ে দেখেছি। ডেটা প্রস্তুতি থেকে প্রি-ট্রেনিং, তারপর চ্যাট করতে শেখানোর ইনস্ট্রাকশন টিউনিং (SFT)—সবই নিজের পিসিতে করেছি।
আগেই ফলাফলটা বলি, মোটামুটি এমন:
- প্রি-ট্রেনিং প্রায় ২১ ঘণ্টায় শেষ। সাধারণ জ্ঞানভিত্তিক রিজনিং টেস্ট HellaSwag-এ 30.5%। মূল GPT-2 124M-এর 29.4%-কে ছাড়িয়েছে
- SFT-তে দুই ঘণ্টারও কম সময়। প্রশিক্ষণ শুরুর মাত্র ৫ মিনিটের মধ্যে কথোপকথনের মতো উত্তর দিতে শুরু করে
- তবে ভেতরে হ্যালুসিনেশন ভরপুর। অনায়াসে বলে, “প্যারিসের জনসংখ্যা ২.৪ বিলিয়ন”, “12+7=30”
GPT-2-কে ধীরে ধীরে বুদ্ধিমান হতে দেখা বেশ মজার ছিল, তাই পুরো প্রক্রিয়াটা এখানে সংক্ষেপে লিখে রাখছি।
পরিবেশ
- GPU: RTX 4090(24GB)
- CPU: i7-13700K / মেমরি 64GB
- OS: Windows 11(WSL ব্যবহার করিনি, সরাসরি Windows-এ)
- PyTorch 2.11 nightly(CUDA 12.8)+ triton-windows
কোডের পদ্ধতিটি Karpathy-এর nanoGPT/build-nanogpt-এর মতোই। Claude Code-কে বলেছিলাম, “এই পিসির GPU-তে এক দিনে যতটা সম্ভব GPT-2 বানিয়ে দাও”; কনফিগারেশন প্রস্তাব থেকে স্ক্রিপ্ট তৈরি, প্রশিক্ষণ মনিটর করা পর্যন্ত একসঙ্গে করেছে।
ডেটা প্রস্তুতি: ১০B টোকেন তৈরি ১২ মিনিটে
প্রশিক্ষণ ডেটা হিসেবে নিয়েছি FineWeb-Edu—শিক্ষামূলক, উচ্চমানের ইংরেজি ওয়েব টেক্সটের ১০B টোকেন সংস্করণ। parquet আকারে প্রায় 27GB।
শুরুতে খালি Hugging Face ডাউনলোডে গতি ছিল মাত্র 1.7MB/s; সব নামাতে ৪ ঘণ্টারও বেশি লাগার কথা। hf_transfer ইনস্টল করার পর গতি 60〜70MB/s হলো, 2GB ফাইল ৩০ সেকেন্ডে নেমে আসে। বাধা তখন টোকেনাইজিংয়ে সরে যায়, আর ডাউনলোড ও টোকেনাইজিং মিলিয়ে প্রায় ১২ মিনিটে সব প্রস্তুত।
উল্লেখ্য, প্রথমে ক্যাশের অবস্থান বদলানোর HF_HOME আমি huggingface_hub ইমপোর্টের পরে লিখেছিলাম, তাই সেটিং কাজ করেনি এবং অন্য ড্রাইভে ডাউনলোড হচ্ছিল। এই এনভায়রনমেন্ট ভ্যারিয়েবলটি ইমপোর্টের সময় পড়া হয়, তাই ইমপোর্টের আগেই সেট করতে হবে। ছোটখাটো, কিন্তু বেশ ফাঁদে ফেলে।
প্রশিক্ষণের সেটিংস
| বিষয় | বিবরণ |
|---|---|
| মডেল | GPT-2 small(12 স্তর・768 ডাইমেনশন, ১২ কোটি ৪০ লাখ প্যারামিটার) |
| ১ স্টেপ | প্রায় ৫.২ লাখ টোকেন(16×1024, 32 বার গ্রেডিয়েন্ট অ্যাকিউমুলেশন) |
| স্টেপ সংখ্যা | 16,000(প্রায় 8.4B টোকেন) |
| গতি | প্রায় ১.২ লাখ টোকেন/সেকেন্ড |
| VRAM | প্রায় 12GB |
Windows-এ torch.compile চলে না, তাই WSL ব্যবহার করতে হয়—এমন কথা প্রায়ই শোনা যায়; কিন্তু triton-windows থাকা পরিবেশে এটি সরাসরি চলেছে।
পুরো 10B টোকেনে ২৪ ঘণ্টার বেশি লাগত, তাই এক দিনের মধ্যে রাখতে 8.4B টোকেনে নামিয়ে এনেছি।
ছোট একটি কৌশল হিসেবে, ভোকাবুলারির আকার 50257 থেকে 50304(128-এর গুণিতক)-এ বাড়িয়েছি। GPU-র ম্যাট্রিক্স হিসাব দ্রুত করার Karpathy-এর পরিচিত কৌশল এটি, আর পরে চ্যাটে রূপান্তরের সময় অপ্রত্যাশিতভাবে কাজে লেগেছে।
ঘটনা: ২.৫ ঘণ্টায় প্রশিক্ষণ থেমে গেল
মাঝপথের অবস্থা দেখতে গিয়ে দেখি প্রশিক্ষণ বন্ধ। কারণ HellaSwag-এর মূল্যায়ন ডেটা। nanoGPT-ধাঁচের কোড GitHub-এর rowanz/hellaswag থেকে ডেটা আনে, কিন্তু সেখানে “451 Unavailable For Legal Reasons”(আইনি কারণে প্রকাশনা বন্ধ)দেখাচ্ছিল। 404 ত্রুটিতে মূল্যায়নের সঙ্গে প্রশিক্ষণও বন্ধ হয়ে যায়।
Hugging Face-এর Rowan/hellaswag(ভেতরের একই 10,042টি প্রশ্ন)থেকে পড়ার ব্যবস্থা করি, এবং প্রতি 500 স্টেপে রাখা চেকপয়েন্ট থেকে আবার শুরু করি। মূল্যায়ন ব্যর্থ হলেও যেন প্রশিক্ষণ না থামে, সে জন্য try/except দিয়ে ঘিরে দিই।
দীর্ঘ প্রশিক্ষণে, মূল্যায়ন বা লগের মতো “মূল কাজের বাইরের” ব্যর্থতার কারণে প্রশিক্ষণ থামানো যাবে না। এটা গুরুত্বপূর্ণ।
ফলাফল: মূল GPT-2-কে ছাড়িয়ে গেল
ভ্যালিডেশন ডেটার loss ছিল এমন। প্রথম ঘণ্টায় দ্রুত কমেছে, তারপর ধীরে ধীরে নেমেছে।
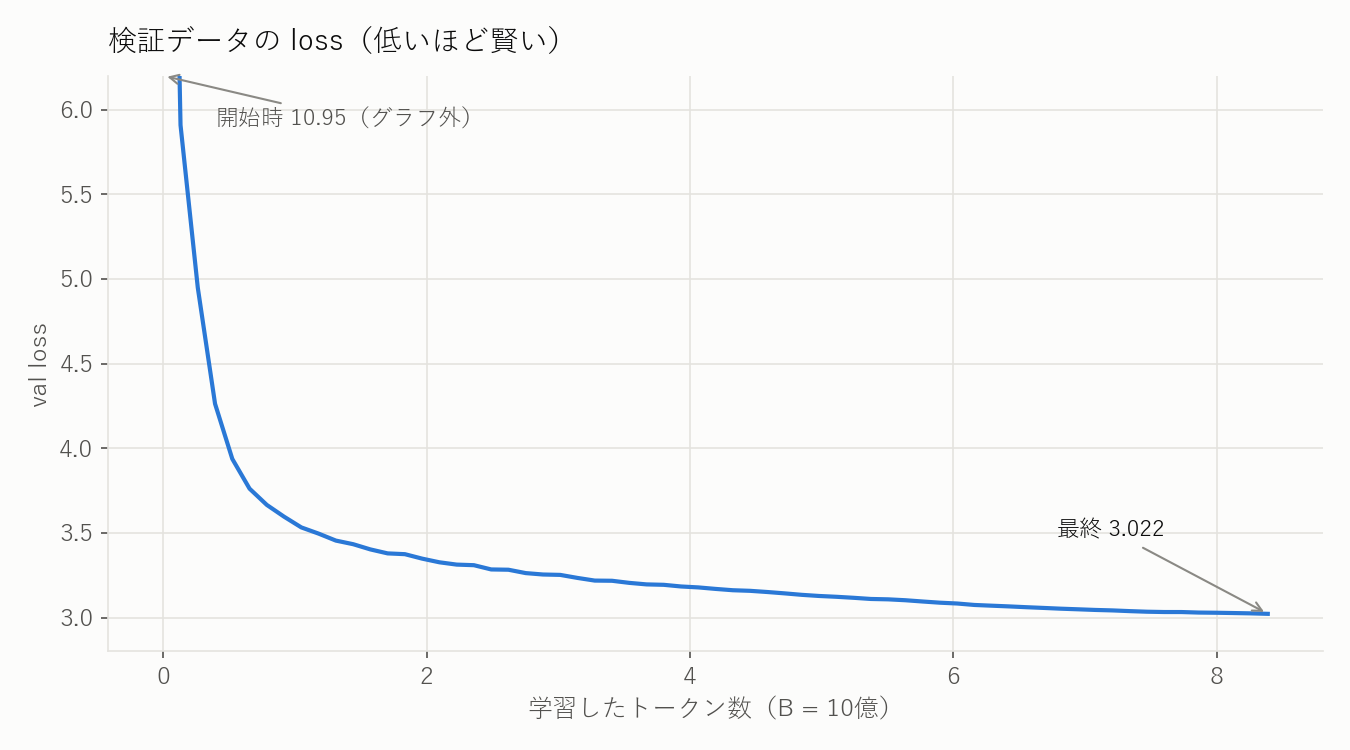
শুরুর loss 10.95 প্রায় ln(50304)≒10.83-এর সমান। অর্থাৎ ৫০ হাজার শব্দের মধ্য থেকে সম্পূর্ণ আন্দাজে বেছে নেওয়ার অবস্থা থেকেই শুরু করেছে।
HellaSwag-এর সঠিক উত্তরের হার এমন:
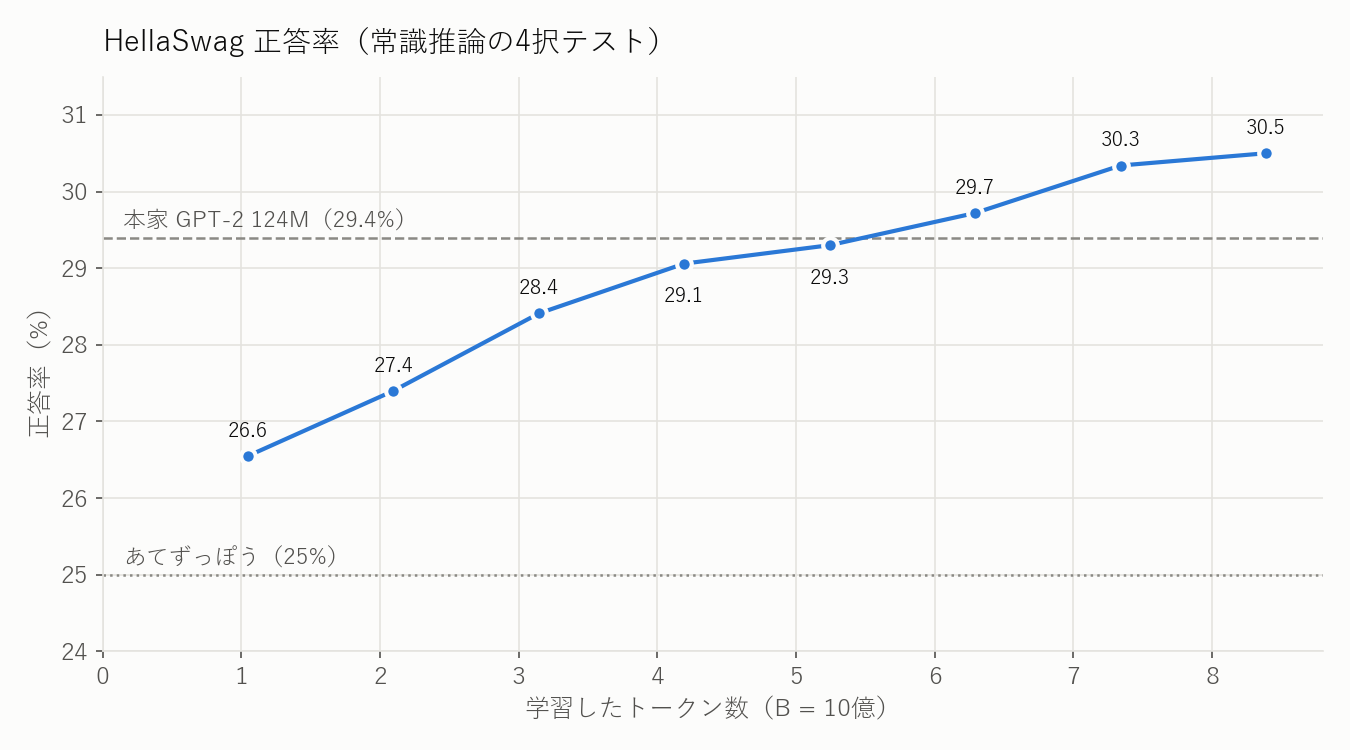
প্রায় 6.3B টোকেনে(step 12,000)মূল GPT-2 124M-এর 29.4%-কে ছাড়িয়ে শেষে 30.5% হয়েছে। মূল GPT-2 WebText-এ প্রশিক্ষিত। এটি FineWeb-Edu-তে প্রশিক্ষিত; শিক্ষামুখী উচ্চমানের ডেটা ব্যবহার করাটাই সম্ভবত কাজে দিয়েছে।
ধীরে ধীরে বুদ্ধিমান হয়ে ওঠার দৃশ্য
প্রশিক্ষণের সময় প্রতি ঘণ্টায় একই প্রম্পট দিয়ে লেখা তৈরি করে সংরক্ষণ করেছি। এটাই ছিল সবচেয়ে মজার অংশ।
প্রশিক্ষণের আগে(এলোমেলো অবস্থা)
Hello, I'm a language model,CHR 351ointment Education rodents Effectiveantically emulatorprot grievance...
শব্দগুলো কেবল পুরোপুরি এলোমেলোভাবে সাজানো।
৩৭ মিনিট পরে(0.26B টোকেন)
The capital of France is a capital trade market ... is often referred to as the capital city of Scotland
বাক্যের আকার এসেছে। “রাজধানীর কথা” বুঝলেও ফ্রান্সের রাজধানীকে স্কটল্যান্ডের রাজধানী বলছে।
প্রায় ২ ঘণ্টা পরে(0.79B টোকেন)
Photosynthesis is the process by which oxygen gas is converted into ammonia by removing the nitrogen hydroxylates (NTP).
ব্যাকরণ বেশ স্বাভাবিক হয়ে গেছে। বদলে, বিশেষজ্ঞসুলভ শব্দ সাজিয়ে বিশ্বাসযোগ্য শোনানো মিথ্যা বলতে শুরু করেছে। হ্যালুসিনেশনের প্রাথমিক রূপ যেন।
প্রায় 2.1B টোকেন
The capital of France is Paris, and the country is also France. France makes approximately 50% of the world's steel production.
অবশেষে Paris বলতে পারল! …কিন্তু সঙ্গে সঙ্গেই “ফ্রান্স বিশ্বের ৫০% ইস্পাত উৎপাদন করে” বলে ভুয়া পরিসংখ্যান জুড়ে দিল।
সম্পন্ন বেস মডেলকে প্রশ্ন করে দেখলাম
Question: ... Answer: ফরম্যাটে ১০টি প্রশ্ন করেছি।
- What is the capital of France? → (a)〜(i) বিকল্প সাজিয়ে প্রশ্নপত্র বানাতে শুরু করে
- Who was Albert Einstein? → “1918 সালের 16 নভেম্বর, মিসৌরির সেন্ট লুইসে জন্ম। বাবা ছিলেন খনি শ্রমিক, আর তিনি নিজে স্কুলশিক্ষক।” সবই মিথ্যা, কিন্তু জীবনীসুলভ ভঙ্গিতে লিখতে পারে
- What is 12 plus 7? → “12 plus 7 is an arithmetic expression.”। হিসাব না করে সংজ্ঞা বলা শুরু করে
কিছুটা জ্ঞান আছে, কিন্তু “প্রশ্নের উত্তর দেওয়া” আচরণটি জানে না। বেস মডেল আসলে কেবল “লেখার পরের অংশ লিখে যাওয়ার” যন্ত্র, তাই এটাই স্বাভাবিক।
SFT দিয়ে চ্যাট করতে শেখালাম
এবার ChatGPT-এর মতো প্রশ্নের উত্তর দিতে শেখানোর জন্য ইনস্ট্রাকশন টিউনিং(SFT) করেছি।
- ডেটা: Hugging Face-এর
smol-smoltalk(প্রায় ৪.৬ লাখ কথোপকথন, ২.৭ কোটি টোকেন) - চ্যাট ফরম্যাট:
<|user|><|assistant|><|end|>-এর মতো বিভাজক চিহ্ন যোগ করেছি। এখানে আগে ভোকাবুলারি 50304-এ বাড়ানোর সময় পাওয়া ফাঁকা নম্বরগুলো পুনর্ব্যবহার করেছি। মডেলের কাঠামো না বদলিয়েই বিশেষ টোকেন যোগ করা গেছে, ফলে গতির জন্য করা কৌশলটি এখানে কাজে লেগেছে - শুধু উত্তরের অংশ শেখানো: প্রশ্ন শুধু পড়ে, অনুকরণ করানো হয় অ্যাসিস্ট্যান্টের উত্তর এবং শেষে থাকা
<|end|> - ২ এপক, প্রায় ১ ঘণ্টা ৫০ মিনিট
মূল বিষয় হলো <|end|> পর্যন্ত শেখানো। এতে মডেল কথা শেষ হলে নিজেই থামতে শেখে। ChatGPT-ও শেষের চিহ্ন তৈরি হলে জেনারেশন থামায়—একই ব্যবস্থা।
মাত্র ৫ মিনিটেই কথোপকথনের মতো
SFT শুরুর আগে(step 0), অপরিচিত বিভাজক চিহ্নে বিভ্রান্ত হয়ে “jakjakjakjak…” অনন্ত লুপে পড়ছিল। কিন্তু 500 স্টেপ(প্রায় ৫ মিনিট)পরই কথোপকথনের মতো হয়ে যায়।
The capital of France, Paris, is a city known for its numerous landmarks, including the Eiffel Tower, Louvre Museum, and Notre-Dame Cathedral.
উপরন্তু, ঠিকমতো শেষ করে থেমেও যায়। বলার ধরন শেখা ছিল মুহূর্তের ব্যাপার।
তবে জ্ঞান আগের মতোই। মাঝের একটি মডেল বলেছিল, “প্যারিস বিশ্বের সবচেয়ে বড় শহর, জনসংখ্যা প্রায় 2.4 বিলিয়ন।”
SFT-এর আগে ও পরে তুলনা
একই প্রশ্নে SFT-পূর্ব(বেস মডেল)ও পরের ফল তুলনা করেছি।
| প্রশ্ন | SFT-এর আগে | SFT-এর পরে |
|---|---|---|
| What is the capital of France? | (a)〜(i) বিকল্প সাজাতে শুরু করে | “The capital of France, Paris, is a city located in the northern part of the country, along the Seine River.” |
| Who are you? | “I am the person who has the gift for all that I do.” | “I'm a language learning AI assistant with over 10 years of experience”(AI হয়েও ১০ বছরের অভিজ্ঞতা) |
| Translate "Good morning" into French. | প্রশ্নের সঙ্গে সম্পর্কহীন কথা শুরু করে | “Bonjour!”(সঠিক। কিন্তু পরে “Good morning (modifier)” অবিরাম পুনরাবৃত্তি করে) |
| What is 12 plus 7? | “arithmetic expression” বলে | “12 + 7 = 21”→“12 + 7 = 30”→“35 + 7 = 34”—বিশ্বাসযোগ্য পদ্ধতিতে ক্রমেই ভুল করতে থাকে |
| Who was Albert Einstein? | বাবা খনি শ্রমিক, নিজে স্কুলশিক্ষক | “prominent physicist”—বড় ছবিটা ঠিক। কিন্তু “1905 সালের 24 ফেব্রুয়ারি ভিয়েনায় জন্ম” মিথ্যা |
ভাষাভঙ্গি ও ফরম্যাট পুরোপুরি অ্যাসিস্ট্যান্টের মতো। ভেতরের তথ্য অবশ্য বেশিরভাগই মিথ্যা। গণিতে একেবারেই ব্যর্থ ছিল।
সত্যি সত্যি চ্যাট করে দেখলাম
টার্মিনালে কথা বলার জন্য chat.py তৈরি করে কথা বলেছি।
You: What is the capital of Japan? Answer in one sentence.
AI: The capital of Japan is Tokyo, a city known for its historical landmarks and cultural significance.
“এক বাক্যে” নির্দেশটি অনুসরণ করতে পারছে। বেস মডেলের পক্ষে এটি সম্ভব ছিল না।
অন্য এক কথোপকথনে রাজধানী জিজ্ঞাসার পর, পরপর জনসংখ্যা জিজ্ঞেস করেছি।
You: What is the population there?
AI: In Japan, the population is estimated to be around 50,000 people. ... the northern part of the country, where about 1.5 billion people live...
আগের কথোপকথন ধরে “there=জাপান” বুঝেছে। কিন্তু জাপানের জনসংখ্যা ৫০ হাজার বলার পরই আবার উত্তরে বলছে উত্তরের অংশে ১.৫ বিলিয়ন মানুষ থাকে—একেবারে এলোমেলো।
জাপানিতে “জাপানের রাজধানী কী?” জিজ্ঞেস করলে এমন উত্তর দেয়:
AI: I'm ready to help you with your writing. Please go ahead and provide the text...
শুধু ইংরেজি ডেটায় প্রশিক্ষিত হওয়ায়, জাপানিকে সম্ভবত “সম্পাদনা করতে চাওয়া রহস্যময় লেখা” মনে হয়েছে।
শেষে “GPU নিয়ে একটি হাইকু লেখো” বললে, “I see the world, the thoughts, the emotions” অবিরাম পুনরাবৃত্তি করা কবিতা লিখেছে। হাইকু কোথায়!
করে যা বুঝলাম
- একটি 4090 দিয়েই, এক দিনে মূল GPT-2-কে ছাড়িয়ে যাওয়া মডেল বানানো যায়। GPU-র বিদ্যুৎ খরচ ছিল প্রায় 430W। শুধু GPU-র বিদ্যুৎ বিল মোটামুটি ৩০০ ইয়েন(অনুমান)
- কথার ধরন মুহূর্তেই শেখে, কিন্তু জ্ঞান নির্ধারিত হয় প্রি-ট্রেনিংয়ে। SFT মাত্র ৫ মিনিটে কথোপকথনের ফরম্যাটে নিয়ে গেছে, কিন্তু তথ্যের নির্ভুলতা প্রায় বদলায়নি
- 124M মডেলের ব্যাকরণ প্রায় নিখুঁত, কিন্তু ভেতরের তথ্য মিথ্যায় ভরা। সাবলীলতা ও সঠিকতা যে আলাদা বিষয়, তা হাতেকলমে বোঝা যায়
- দীর্ঘ প্রশিক্ষণ ভেঙে পড়ে অবকাঠামোগত সমস্যায়। এবার থেমেছিল মডেলের কারণে নয়, মূল্যায়ন ডেটার অবস্থানটি আর উপলব্ধ না থাকায়
নিজে শূন্য থেকে বানালে বোঝা যায়, ChatGPT-এর মতো AI মূলত “লেখার পরের অংশ অনুমান করার যন্ত্র”-কে “কথোপকথনের শিষ্টাচার” শেখানোর ফল। পরের বার একটু বেশি ব্যবহারিক মডেলও বানিয়ে দেখতে চাই।