৩,২০০ লাখ প্যারামিটার দিয়ে ক্রোয়েশীয় ভাষার স্পিচ সিন্থেসিস মডেল বানালাম: প্রশিক্ষণের বিভিন্ন ধাপের কণ্ঠ তুলনা
ক্রোয়েশীয় ভাষার RAG-এর জন্য LLM-এর পর, এবার ক্রোয়েশীয় ভাষার জন্য ছোট একটি স্পিচ সিন্থেসিস (TTS) মডেল বানালাম। লক্ষ্য হলো এটি যেন স্মার্টফোনের CPU-তে রিয়েল-টাইমে চলে।
পদ্ধতিটি হলো “ডিস্টিলেশন”। বড় একটি স্পিচ সিন্থেসিস মডেল (HiggsAudio v3) দিয়ে ক্রোয়েশীয় স্ক্রিপ্ট পড়িয়ে প্রশিক্ষণ ডেটা তৈরি করেছি, তারপর সেই ডেটা দিয়ে ছোট মডেলটিকে শুরু থেকে প্রশিক্ষণ দিয়েছি। এবার প্রথমে ৭.৫ ঘণ্টার ডেটা দিয়ে পাইলট প্রশিক্ষণ চালিয়েছি এবং একই বাক্যটি প্রশিক্ষণের সঙ্গে কীভাবে বদলায় তা শুনে তুলনা করেছি।
আগে ফলাফল বলি।
- ৩,২০০ লাখ প্যারামিটার (Matcha-TTS ১,৮৩০ লাখ + Vocos ১,৩৫০ লাখ) নিয়েও মডেলটি ঠিকমতো ক্রোয়েশীয় ভাষায় কথা বলেছে
- প্রশিক্ষণের ৫০ মিনিটে (৫,০০০ ধাপে) এটি স্ক্রিপ্ট অনুযায়ী পড়তে পারছিল। এরপর মূলত যে বিষয়টি উন্নত হয়েছে, তা হলো “নয়েজ”
- মূল্যায়নের ১৪টি বাক্যে চূড়ান্ত অক্ষর-ত্রুটির হার ছিল ০.৯% (১৪টির মধ্যে ১০টি পুরোপুরি মিলে গেছে)
- একটি CPU থ্রেডেই ১ সেকেন্ডের অডিও ০.০৯ সেকেন্ডে তৈরি করা গেছে (i7-13700K)
ডেমো: আসলেই কথা বলিয়ে দেখুন
ক্রোয়েশীয় TTS প্লেগ্রাউন্ড-এ এই নিবন্ধের মডেলটি (চূড়ান্ত ৩০,০০০-ধাপের সংস্করণ) রেখেছি। পছন্দের ক্রোয়েশীয় লেখা দিলে এটি সঙ্গে সঙ্গেই পড়ে শোনাবে।
- ৫০টি উদাহরণ বাক্য (অভিবাদন, ভ্রমণ, হাসপাতাল ইত্যাদি) থেকে বেছে নিতে পারেন, অথবা নিজের লেখা সর্বোচ্চ ১,০০০ অক্ষর পর্যন্ত দিতে পারেন
- কথার গতি, স্বরভঙ্গির মাত্রা ও সিন্থেসিসের ধাপের সংখ্যা বদলানো যায়। সিড স্থির রাখলে একই বাক্যে প্রতিবার একই অডিও তৈরি হবে
- সিন্থেসিস কেবল সার্ভারের CPU-তেই চলছে (ONNX Runtime ব্যবহার করা হয়েছে; GPU বা বাইরের API নয়)
- এটি সংখ্যা পড়তে পারে না, তাই “dvadeset pet(25)”-এর মতো শব্দে লিখতে হবে
যা করেছি
1. স্ক্রিপ্ট তৈরি: স্থানীয় Gemma 4 31B দিয়ে ক্রোয়েশীয় দৈনন্দিন কথোপকথনের সংলাপ লিখিয়েছি। “বাজারে দাদির সঙ্গে কথা বলছে”, “মাঝরাতে অদ্ভুত শব্দ শুনে ভয় লাগছে”—এমন পরিস্থিতি, কথোপকথনের সঙ্গী, আবেগ ও দৈর্ঘ্য এলোমেলোভাবে নির্দিষ্ট করে, প্রতিবার ২২ লাইন করে। বক্তা হিসেবে ৩০-এর কোঠার একজন নারীর সেটিং ব্যবহার করেছি। ২৩ ধরনের আবেগ (স্বাভাবিক, আনন্দ, রাগ, ফিসফিস ইত্যাদি) মেশানো হয়েছে।
2. অডিও তৈরি: HiggsAudio v3-কে রেফারেন্স অডিওর (১৬ সেকেন্ড) কণ্ঠে স্ক্রিপ্ট পড়িয়েছি। আবেগের ট্যাগ (<|emotion:anger|> ইত্যাদি) দিলে সেটি সত্যিই রাগ বা আনন্দের ভাব প্রকাশ করে। প্রায় ৫ ঘণ্টায় ৪,৫০০টি তৈরি করেছি।
3. স্বয়ংক্রিয় পরীক্ষা: Whisper large-v3 দিয়ে প্রতিলিপি তৈরি করে স্ক্রিপ্টের সঙ্গে মিলিয়েছি এবং ভুল পড়াগুলো বাদ দিয়েছি। পাশাপাশি স্পিকার-রিকগনিশন মডেল দিয়ে রেফারেন্স অডিওর সঙ্গে কণ্ঠের সাদৃশ্য মেপেছি; কণ্ঠ বদলে যাওয়া নমুনাগুলোও বাদ দিয়েছি। উত্তীর্ণ হয়েছে ৪,৫০০টির মধ্যে ৪,৩৯৩টি (৯৭.৬%)। শুরু ও শেষের নীরবতা কেটে দিলে মোট সময় দাঁড়ায় ৭.৪৬ ঘণ্টা।
4. ছোট মডেল প্রশিক্ষণ: RTX 4090-এ Matcha-TTS (ফ্লো ম্যাচিং পদ্ধতির TTS) ৫ ঘণ্টা প্রশিক্ষণ দিয়েছি। প্রায় ৩০,০০০ ধাপ। অডিও তরঙ্গরূপে ফেরানোর অংশটি (ভোকোডার) প্রকাশিত Vocos-ই অপরিবর্তিত ব্যবহার করেছি।
ক্রোয়েশীয় ভাষায় সাধারণত যেমন লেখা হয় তেমনই উচ্চারণ করা হয়, তাই এটিকে ধ্বনি-চিহ্নে রূপান্তর না করে অক্ষর সরাসরি ইনপুট দিয়েছি। তবে lj, nj ও dž একটি করে ধ্বনি হওয়ায় এগুলোকে এক অক্ষর হিসেবে নিয়েছি।
প্রশিক্ষণের বিভিন্ন ধাপের অডিও তুলনা
প্রশিক্ষণ ডেটায় নেই এমন বাক্যটি—“Molim Vas, možete li mi reći koliko košta ova haljina?(মাফ করবেন, এই পোশাকটির দাম কত?)”—প্রশিক্ষণের বিভিন্ন পর্যায়ের মডেল দিয়ে সিন্থেসাইজ করেছি।
ধাপ ৫,০০০ (প্রশিক্ষণ শুরুর প্রায় ৫০ মিনিট পর)
ধাপ ১০,০০০ (প্রায় ১ ঘণ্টা ৪০ মিনিট)
ধাপ ১৫,০০০ (প্রায় ২ ঘণ্টা ২০ মিনিট)
ধাপ ২০,০০০ (প্রায় ৩ ঘণ্টা ১০ মিনিট)
ধাপ ৩০,০০০ (প্রায় ৫ ঘণ্টা, চূড়ান্ত)
তুলনার জন্য, শিক্ষক হিসেবে থাকা HiggsAudio যে প্রশিক্ষণ ডেটা তৈরি করেছে তার একটি নমুনা (অন্য বাক্য: “Samo polako hodajte, nema potrebe da žurimo kroz ovaj mrak.”)।
Whisper দিয়ে প্রতিলিপি করলে, এই বাক্যটি ধাপ ৫,০০০ থেকে শেষ পর্যন্ত প্রতিবারই স্ক্রিপ্টের সঙ্গে অক্ষরে অক্ষরে মিলেছে। অর্থাৎ, “কী বলছে” সেটি শুরু থেকেই ঠিক ছিল।
পার্থক্যটা শব্দের স্বচ্ছতায়। শুনে মনে হয়েছে, ধাপ ৫,০০০-এ খসখসে নয়েজ ছিল, যা ধাপ ১০,০০০-এ অনেকটাই কমে যায়। একই অডিওকে স্পেকট্রোগ্রামে (অনুভূমিক অক্ষে সময়, উল্লম্ব অক্ষে ফ্রিকোয়েন্সি) দেখলে বিষয়টি স্পষ্ট হয়।
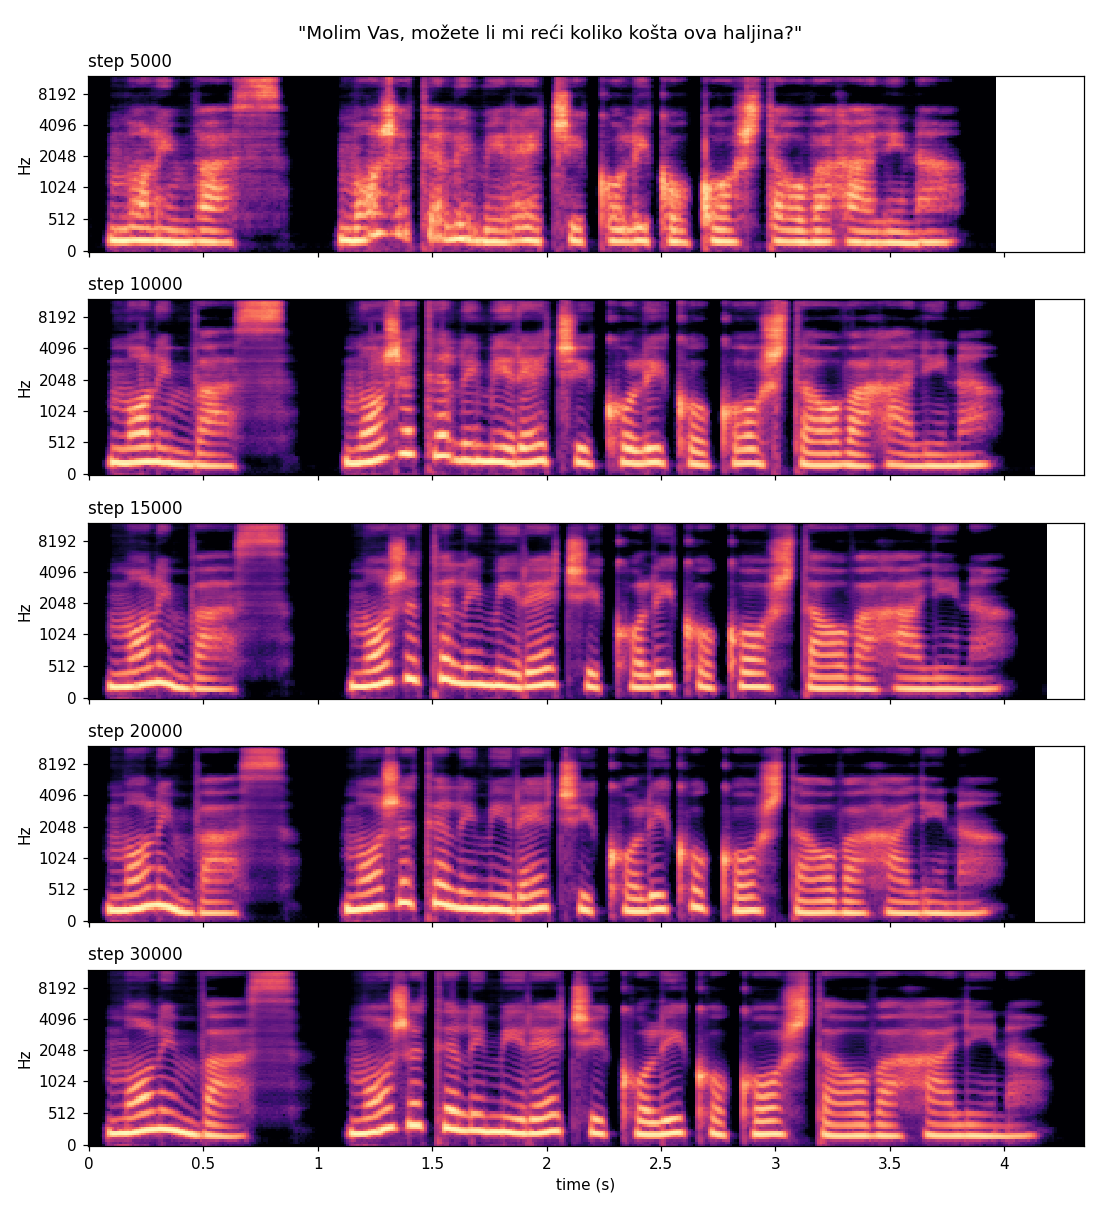
কণ্ঠের উচ্চতার সঙ্গে সাজানো অনুভূমিক ডোরা (হারমোনিক) ধাপ ৫,০০০-এ ঝাপসা; ডোরাগুলোর ফাঁক কুয়াশার মতো ভরাট। এ অংশটিই নয়েজ হিসেবে শোনা যায়। ধাপ ১০,০০০-এর পর ডোরাগুলো স্পষ্ট হয় এবং ফাঁকগুলো গাঢ় হয়। প্রশিক্ষণ এগোনোর সঙ্গে ডোরাগুলো ওপর-নিচে মসৃণ বাঁক নিতে থাকে; কণ্ঠের উচ্চতার পরিবর্তন (স্বরভঙ্গি)ও আরও পরিষ্কার হয়ে ওঠে বলে মনে হয়।
সংখ্যায় দেখা
মূল্যায়নের ১৪টি বাক্য (সবই প্রশিক্ষণ ডেটার বাইরে) Whisper large-v3 দিয়ে প্রতিলিপি করে অক্ষর-ত্রুটির হার (CER) মেপেছি। এতে ছোট অভিবাদন থেকে প্রায় ১৬ সেকেন্ডের স্বগতোক্তিও রয়েছে।
| ধাপ | প্রশিক্ষণের সময় | অক্ষর-ত্রুটির হার | সম্পূর্ণ মিল |
|---|---|---|---|
| ৫,০০০ | প্রায় ৫০ মিনিট | ১.১% | ৯ / ১৪ |
| ১০,০০০ | প্রায় ১ ঘণ্টা ৪০ মিনিট | ৩.৪% | ৮ / ১৪ |
| ১৫,০০০ | প্রায় ২ ঘণ্টা ২০ মিনিট | ০.৭% | ১১ / ১৪ |
| ২০,০০০ | প্রায় ৩ ঘণ্টা ১০ মিনিট | ০.৯% | ১১ / ১৪ |
| ৩০,০০০ | প্রায় ৫ ঘণ্টা | ০.৯% | ১০ / ১৪ |
- ধাপ ১০,০০০-এ সংখ্যাটি খারাপ হওয়ার মূল কারণ প্রায় পুরোপুরি একটি বাক্য: “Bok!(হাই)”-কে “Vok” হিসেবে শনাক্ত করা হয়েছিল। তিন অক্ষরের মধ্যে এক অক্ষরের পার্থক্য হওয়ায় শুধু এই বাক্যটিরই ত্রুটির হার ৩৩%। কিন্তু শুনলে ধাপ ১০,০০০-এর অডিও ধাপ ৫,০০০-এর চেয়ে অনেক পরিষ্কার ছিল। অক্ষর-ত্রুটির হার কেবল “পড়তে পারছে কি না” মাপে; শব্দের স্বচ্ছতা শুনেই বিচার করতে হয়
- শেষ পর্যন্ত থাকা ভুলটি ছিল “Đak je pojeo džem(ছাত্রটি জ্যাম খেয়েছে)”-এর đ ও dž। ক্রোয়েশীয় ভাষাতেও এগুলো কম ব্যবহৃত ধ্বনি, এবং এগুলোকে “Žak”, “Džak” হিসেবে শনাক্ত করা হয়েছিল
CPU-তে গতি
i7-13700K-এ PyTorch-এর অপরিবর্তিত সংস্করণে (অপ্টিমাইজেশন ছাড়া) মাপা হয়েছে। ৪টি বাক্যে মোট ৪৭.৬ সেকেন্ডের অডিও ৩ বার তৈরি করে গড় নেওয়া হয়েছে। RTF হলো “তৈরিতে লাগা সময় ÷ অডিওর দৈর্ঘ্য”; যত কম, তত দ্রুত।
| থ্রেড সংখ্যা | ধাপ সংখ্যা | Matcha | Vocos | মোট RTF |
|---|---|---|---|---|
| ১ | ২ | ০.০৪২ | ০.০২৫ | ০.০৬৭ |
| ১ | ৪ | ০.০৬৭ | ০.০২৫ | ০.০৯২ |
| ৪ | ৪ | ০.০৩২ | ০.০১০ | ০.০৪২ |
| ৮ | ৪ | ০.০২৮ | ০.০০৭ | ০.০৩৬ |
“ধাপের সংখ্যা” হলো সিন্থেসিসের সময় নয়েজ থেকে অডিও তৈরির পুনরাবৃত্তির সংখ্যা; উপরের শোনার তুলনাটি ৪ ধাপে তৈরি। এক থ্রেডেই ১ সেকেন্ডের অডিও ০.০৯ সেকেন্ডে তৈরি করা যায়। স্মার্টফোনের CPU এর চেয়ে ধীর হবে, তবে রিয়েল-টাইমে চলার কথা (এখনও আসল ডিভাইসে মাপিনি, তাই এটি অনুমান)।
TTS-এর জন্য কত ঘণ্টার ডেটা দরকার?
৭.৫ ঘণ্টায় এতদূর আসা গেছে বলে সাধারণ নির্দেশকগুলো খুঁজে দেখেছি।
- একজনের কণ্ঠের TTS-এ বহুল ব্যবহৃত ইংরেজি LJSpeech-এ আছে প্রায় ২৪ ঘণ্টা। Matcha-TTS-এর অফিসিয়াল মডেলও এটি দিয়ে প্রশিক্ষিত
- জাপানি JSUT ও চীনা CSMSC-তে আছে প্রায় ১০ ঘণ্টা, এবং একক কণ্ঠের করপাস হিসেবে এগুলো নিয়মিত ব্যবহৃত হয়
- শুরু থেকে প্রশিক্ষণ দিতে হলে প্রায় ১ ঘণ্টাকে নিম্নসীমা ধরা হয়; মডেলভেদে উচ্চারণ-ভুল বাড়তে পারে
- আগে থেকে প্রশিক্ষিত মডেলকে অতিরিক্ত প্রশিক্ষণ দিলে, ৩০ মিনিটে শুরু থেকে ২৭ ঘণ্টা প্রশিক্ষণের কাছাকাছি ফল পাওয়া গেছে—এমন প্রতিবেদনও আছে
শুধু সিন্থেটিক অডিও দিয়ে Matcha-TTS প্রশিক্ষণের গবেষণা (সাংহাই জিয়াও টং বিশ্ববিদ্যালয়, ডিসেম্বর ২০২৫)-ও পেয়েছি। সেখানে বলা হয়েছে, লেখার বৈচিত্র্য যত বেশি, অডিও যত পরিচ্ছন্ন ও নয়েজমুক্ত, এবং বলার ধরন যত সামঞ্জস্যপূর্ণ—প্রশিক্ষণ তত ভালো হয়। সিন্থেটিক ডেটায় নয়েজ থাকে না এবং বলার ধরনও সামঞ্জস্যপূর্ণ থাকে, তাই একই সময়ের হিসেবে বাস্তব রেকর্ডিংয়ের চেয়ে এটি শেখা সহজ হতে পারে। এবার ৭.৫ ঘণ্টাতেই এতদূর আসার বিষয়টিও তার সঙ্গে মেলে।
যে সমস্যাগুলোতে পড়েছি
- PC জমে গিয়েছিল: স্ক্রিপ্ট তৈরির 31B মডেল ভুল করে একসঙ্গে দুটি GPU-তে লোড হয়ে VRAM উপচে পড়েছিল। এরপর থেকে “GPU-তে একবারে শুধু একটি মডেল” নিয়ম করেছি
- Gemma 4-এর অতিরিক্ত চিন্তা: আউটপুটের প্রায় দুই-তৃতীয়াংশই ছিল “চিন্তা”। চিন্তা বন্ধ করায় গতি প্রায় ৩ গুণ বেড়েছে
- HiggsAudio-এর শ্রুতিভ্রম: প্রথম পরীক্ষায় বাক্যের পরের নীরবতার মধ্যে এটি নিজে থেকেই “Hvala što pratite kanal(চ্যানেল দেখার জন্য ধন্যবাদ)” বলতে থাকে, ফলে একটি ক্লিপ ৮১ সেকেন্ডের হয়েছিল। মনে হয় এটি YouTube-এর সমাপ্তির সংলাপ শিখেছে। প্রত্যাশিত দৈর্ঘ্য থেকে অনেক বেশি ভিন্ন নমুনাগুলো বাদ দেওয়ার ব্যবস্থা করেছি
- Windows-এ Matcha-TTS চলে না: কিছু C এক্সটেনশন বিল্ড করা যায়নি, তাই সেই অংশ Python (numba) দিয়ে আবার লিখেছি